Correction Training · 论文精读扩散模型的矫正训练:不需要 CFG
Correction Training for Diffusion Models
Donghoon Ahn, Runqian Wang, Alexei A. Efros (UC Berkeley) · Taesung Park, Yash Belhe (Reve)
一句话:在去噪器旁边再加一个小网络(corrector),它的任务是把去噪器的预测往干净目标上拉;采样时在每个去噪步内把这个矫正重复 K 次。 这样扩散模型不需要 classifier-free guidance 也能出好图——DiT 2.07、SiT 1.92、SiT-REPA 1.31、JiT 2.96 的 FID, 而且保留多样性、避免 CFG 的过饱和。
01 — 30 秒速览
这篇论文做了什么
扩散模型采样是迭代的:训练时去噪器看到的是「真实图像 + 噪声」;推理时它看到的却是「自己上一步不太准的预测」。
这个训练—推理差距(training–inference gap,也就是暴露偏差)让误差逐步累积——早期出现的结构性错误(比如一张歪掉的嘴)到后期只会被补上细节,而不会被修好。这也是扩散模型没有 CFG 就出不了好图的一个根本原因。
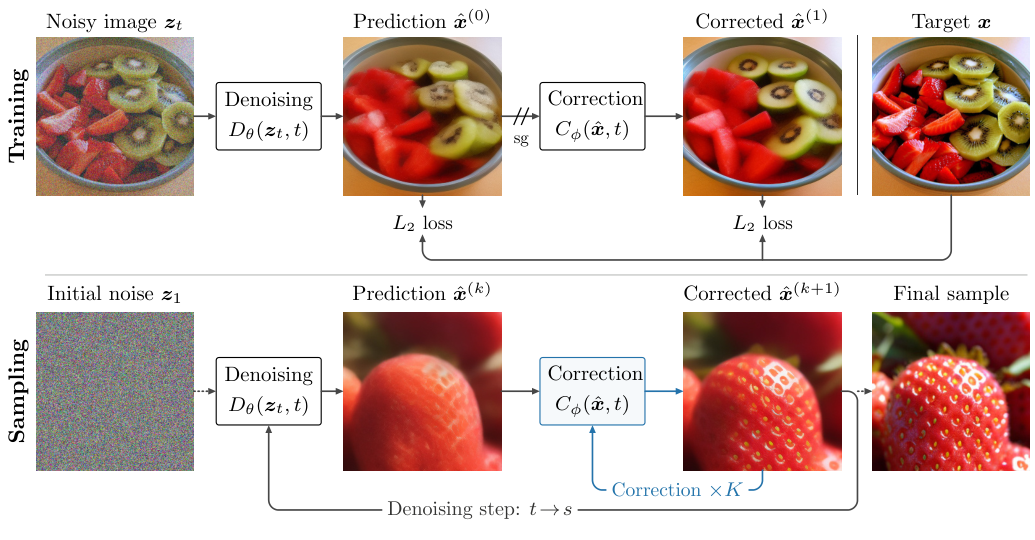
① 加一个矫正网络
Corrector 以去噪器的预测为输入,用与去噪损失相同的干净目标训练它去精修这个预测。stop-gradient 保证矫正损失不会反过来训练去噪器。
② 采样时重复 K 次
每个去噪步:去噪器给一个预测 → 矫正器在同一噪声水平上把这个预测精修 K 次 → 再做去噪步。关键发现是 K > 1 才有效。
③ 摆脱 CFG
无引导生成质量大幅提升,且保留多样性、避免过饱和。与 CFG 组合还能进一步降低 CFG 特有的"AI 味"。
"Correction is an explicit learning task, with training inputs provided by the base model."(矫正被变成了一个显式的学习任务,它的训练输入由基座模型提供。)
02 — 问题
训练—推理差距,以及为什么 CFG 成了标配
2.1 扩散模型的三步循环
- 训练去噪器。输入是真实图像加噪得到的 x_t,网络预测干净图像 x̂,用 L2 损失与真值 x 比较。
- 从噪声采样。推理时没有真实图像。从纯噪声出发,每一步把「当前预测」混合成「下一步更少噪声的输入」。
- 差距出现。若去噪器完美,采样输入的分布会与训练输入完全一致。但学到的去噪器有小误差,每个误差都会被喂进下一步,于是采样输入逐渐漂离训练时见过的分布。
论文给出的实例:SiT-REPA-XL/2 在 ImageNet 256×256 无引导、250 步采样时,第 ~0.6 噪声水平就出现了一张结构不自然的嘴。后续的去噪步主要是在添加牙齿、眼睛与纹理——结构错误被保留并被精细化了。
2.2 现有补救手段的不足
CFG(classifier-free guidance)
几乎成了标配,但有两个众所周知的副作用:模式坍缩(同一 prompt 下布局、姿态、风格趋于雷同)与过饱和(色彩过度浓艳,即所谓"AI 味")。
其它路线
RL 类方法通常需要外部奖励模型;在小型高质量数据集上做监督微调则会牺牲大量多样性。两者都没能完全令人满意——这是论文选择另起炉灶的原因。
03 — 方法
矫正训练与迭代矫正采样
方法本身极其简单,简单到论文自己都说 "The method is very simple."。但它有效的条件却很微妙。
3.1 训练目标
记去噪器 D_θ(z_t, t)、矫正器 C_φ、干净目标 x。去噪损失不变:
矫正损失则把去噪器的预测当作输入(带 stop-gradient),目标是同一个干净 x:
- 同一个目标 x。矫正器学的不是"另一个任务",而是"把同一个任务做得更准"。这让矫正成为显式的学习任务,而不是一个额外的正则。
- stop-gradient。矫正损失不训练去噪器。这样矫正器是在固定的误差分布上学习修复,而不是与去噪器共同漂移。
3.2 采样:去噪 → 矫正 ×K → 下一步
- 去噪器出预测。在噪声水平 t 上得到 x̂⁽⁰⁾。
- 矫正 K 次。在同一噪声水平上反复调用矫正器:x̂⁽ᵏ⁺¹⁾ = C_φ(x̂⁽ᵏ⁾, t),k = 0 … K−1。
- 走一步去噪。用矫正后的 x̂⁽ᴷ⁾ 构造下一步的输入,然后重复。
只在训练时被监督的那一步上使用矫正是不够的;把矫正应用到训练监督之外——即迭代使用——才是质量大幅提升的关键。
换句话说:矫正器在训练时只见过"一步矫正",但推理时你把它循环使用,效果才会爆炸式提升。这打破了一般"训练/推理要一致"的直觉。
3.3 过度矫正:一个真实的失效模式
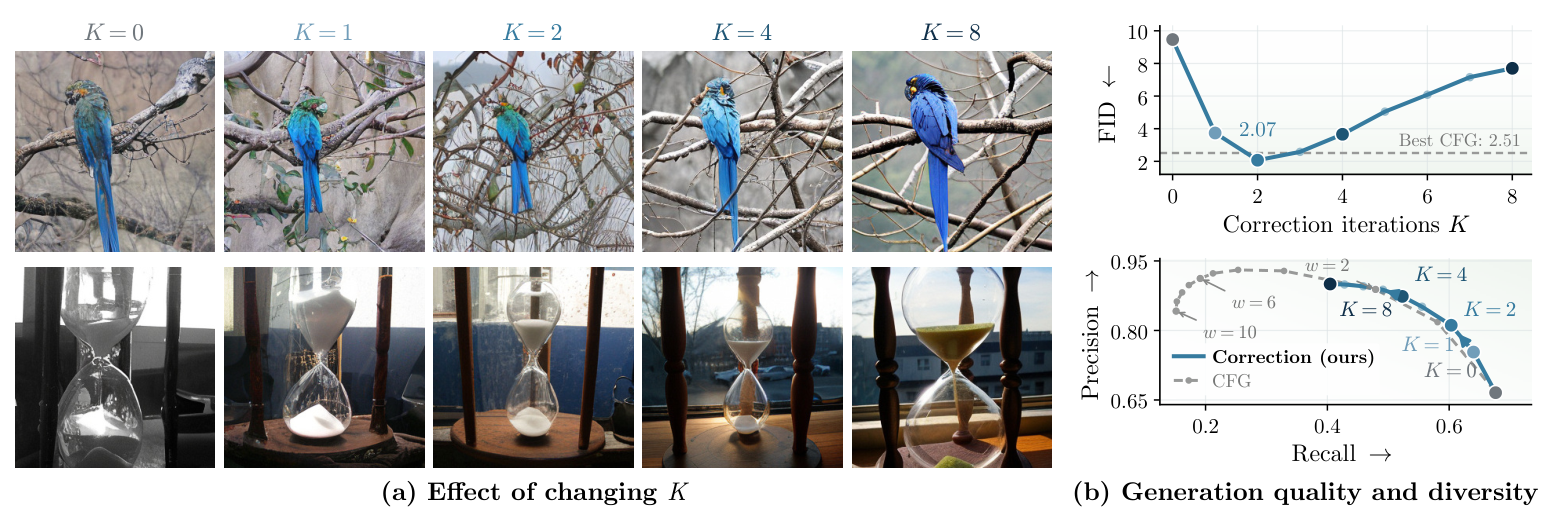
矫正并非越多越好。论文 Figure 13(b) 展示了极端情形:矫正会把含糊的结构推成"过度规则的几何形状"——比如披萨配料变成圆盘状、草莓籽排成规则网格。
论文的直觉解释是:矫正器学到的是一个"朝干净目标修正"的映射;反复把这个映射应用在它自己的输出上,等于把"让结构更连贯"这个偏好不断放大,超出训练时见过的那一次迭代,于是产生过度规则化的图案。
这与 §4.2 的"训练误差反而升高"是同一件事的两面:矫正让预测更"锐利连贯",但也让它们离最优去噪预测更远。所以 K 需要按任务调,而没有一个普适最优值。
3.4 训练方式会影响迭代矫正的效果
联合训练(默认)
去噪器与矫正器一起训练。矫正器暴露在不断变化的误差分布上,因此对不同 K 更鲁棒——K 增大时 FID 持续下降。
冻结去噪器
只训练矫正器。小 K 时与联合训练相当,但K 增大后 FID 反弹,且样本出现结构突变与轻微过饱和(与高 CFG 尺度的趋势类似)。
论文的解释:冻结时矫正器只针对某一个检查点的误差特化,对迭代应用不够鲁棒。
04 — 机制
为什么矫正有效:两个对照实验
4.1 不是"参数变多",而是"重复使用"
最自然的怀疑:矫正器不过是加了参数。论文用一个同算力对照直接排除了这一点(LightningDiT,ImageNet 256×256,从头训练 80K 步,无引导):
| 设置 | 参数量 | 矫正 K | 去噪步数 | 层评估总数 | FID@8K ↓ | FID@50K ↓ |
|---|---|---|---|---|---|---|
| D28(28 层去噪器) | 675M | — | 240 | 6,720 | 8.93 | 4.88 |
| D14 + C14,K = 1 | 681M | 1 | 240 | 6,720 | 8.74 | — |
| D14 + C14,K = 3 | 681M | 3 | 120 | 6,720 | 5.66 | — |
| D14 + C14,K = 4 | 681M | 4 | 96 | 6,720 | 5.56 | — |
| D28 + CFG (w=5) | 675M | — | 120 | 6,720 | 6.17 | — |
| D7 + C7,K = 3(半参数) | 346M | 3 | 240 | 6,720 | 7.51 | 4.21 |
- K = 1 ≈ 单体去噪器(8.74 vs 8.93):从头训练时,把模型拆成去噪器+矫正器本身几乎不带来收益。
- K = 3 大幅胜出(5.66):同样的 6,720 次层评估,只是把算力从"更多步"改配成"每步内重复矫正"。
- 半参数也能赢:D7+C7 只有 346M 参数,FID@50K 4.21 仍优于 675M 的 D28(4.88)。所以不是参数量,而是"重复矫正"这件事本身在起作用。
4.2 权重共享与蒸馏:把开销打下来
| 设置 | 参数量 | FID ↓ | K | NFE |
|---|---|---|---|---|
| 基线(独立去噪器) | 0.68B | 8.55 | 0 | 250 |
| 独立矫正器 | 1.35B | 1.92 | 2 | 249 |
| 共享主干,K = 1 | 0.68B | 4.47 | 1 | 250 |
| 共享主干,K = 3 | 0.68B | 2.14 | 3 | 248 |
| 蒸馏学生(250 步) | 0.68B | 2.04 | — | 250 |
| 蒸馏学生(83 步) | 0.68B | 2.26 | — | 83 |
两个实用的结论:
- 共享主干几乎不掉点:0.68B 的共享配置在 K=3 时 FID 2.14,与 1.35B 独立配置的 1.92 接近——矫正的优势不主要来自参数。
- 蒸馏能省 67% NFE:把矫正后的预测蒸馏回基座去噪器(损失 ℒ_distill = w(t)‖D_θ′(z_t,t) − x̂^(k*)‖²,w(t)=1/t² 即速度空间 MSE),学生在 83 步就达到 2.26。
4.3 训练误差反而升高,但生成质量更好
一个反直觉的关键观察。论文定义矫正后的去噪误差:
并与基线去噪误差相减。结果(Figure 14):k ≥ 3 时差值为正——矫正后的预测离最优去噪预测更远了。
那为什么样本质量还提升?论文的论证是误差在哪里测量:训练误差测的是"真实图像 + 噪声";而采样时去噪器看到的是由它自己早期预测构造出来的状态。生成质量取决于后者上的表现。
为了验证,论文训练了一个分类器做双样本检验(classifier two-sample test):给它一个含噪状态 z_t,判断来自「训练分布」还是「采样轨迹」。若只能瞎猜(AUROC = 0.5),两个分布不可区分,差距为零。在 SiT 的 10 万个中间状态上训练:
K = 0(基线)
分类器轻松区分两者,且噪声越低越容易——误差在采样过程中累积到了靠近数据的一端。
K = 1
BCE 升高、AUROC 下降:矫正缩小了训练—推理差距。
K = 4
差距进一步缩小。这解释了为什么训练误差升高但生成质量更好——矫正器把采样状态拉回了训练分布附近。
它把抽象的"差距"变成了可测量的量(AUROC / BCE,按噪声水平分层),并给出了与直觉相反但自洽的结论:矫正器牺牲了训练分布上的拟合,换取了采样分布上的对齐。这恰好是"暴露偏差"应该被解决的方式。
4.4 外推是关键:训练时见几步,推理时能用几步?
这是论文最反直觉、也最容易被忽略的发现。记训练时监督的矫正次数为 Ktrain(默认 1)。论文扫描了 Ktrain ∈ {1,2,3,4},再看推理时不同 K 的 FID:
| Ktrain \ K | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 2.99 | 1.76 | 1.66 | 2.03 | 2.77 | 3.40 | 3.98 | 4.54 | 4.92 | 5.28 |
| 2 | 3.74 | 2.52 | 1.86 | 1.57 | 1.65 | 1.86 | 2.01 | 2.42 | 2.72 | 2.99 |
| 3 | 4.08 | 2.97 | 2.36 | 1.96 | 1.73 | 1.66 | 1.65 | 1.73 | 1.84 | 2.00 |
| 4 | 4.33 | 3.53 | 3.01 | 2.42 | 2.19 | 2.08 | 1.91 | 1.83 | 1.84 | 1.90 |
最优推理 K 大约是训练监督深度 Ktrain 的两倍("often approximately twice the maximum supervised depth")。
同时,去噪误差只有在 K ≤ Ktrain 时才低于基线;一旦 K > Ktrain(也就是取得最佳 FID 的区间),误差就一直高于基线。
论文对此的措辞很谨慎:"extrapolating the learned correction beyond its training inputs may play an important role in the observed gains."(把学到的矫正外推到训练输入之外,可能才是收益的主要来源。)
这实际上是在说:方法有效的区间,恰好是模型被监督"以外"的区间。也就是说,收益来自分布外泛化,而不是被监督的行为本身。
这既是它有趣的地方,也是它最脆弱的地方——外推没有保证。论文没有解释为什么外推恰好是有益的而不是有害的(只给了一个直觉:"监督更多步只是把同一个修正摊到更多步上")。在一个新任务上,这个外推是否仍然有益,无法先验判断,只能靠扫 K 来验证。
4.5 冻结去噪器行不行?
一个自然会问的问题:能不能冻结预训练去噪器、只训矫正器(这样更省、也不动原模型)?论文对比了联合训练与冻结去噪器两种设置:
- K = 5 时两者 FID 相当;冻结版在小 K 下是有竞争力的。
- 但 K 继续增大后,冻结版的 FID 反而回升——尽管视觉上样本仍在改善。
- 冻结版的样本结构变化更剧烈、并出现轻微过饱和(与高 CFG 尺度的趋势一致)。
如果你不能动原模型(比如只有别人的 checkpoint),冻结方案是可行的,但要小心 K 别调太大。如果可以从头训练,联合训练在 K 增大时更稳。
05 — 结果
ImageNet 与文生图
5.1 类条件 ImageNet-256:无引导 FID
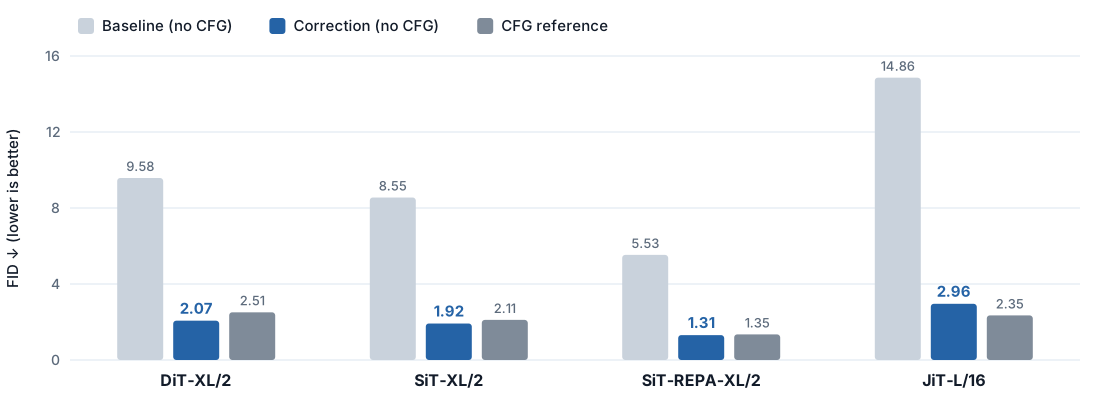
| 模型 | 基线(无引导)FID ↓ | 矫正(无 CFG)↓ | CFG 参考 ↓ |
|---|---|---|---|
| DiT-XL/2 | 9.58 | 2.07 | 2.51 |
| SiT-XL/2 | 8.55 | 1.92 | 2.11 |
| SiT-REPA-XL/2 | 5.53 | 1.31 | 1.35 |
| JiT-L/16 | 14.86 | 2.96 | 2.35 |
- 四个架构上矫正都大幅超过无引导基线(例如 DiT 4.6 倍改善)。
- DiT / SiT / SiT-REPA 三个模型上矫正甚至优于 CFG 参考(2.07 < 2.51;1.92 < 2.11;1.31 < 1.35)。
- 唯一例外是 JiT:矫正 2.96 vs CFG 2.35。论文没有回避这一点——JiT 的架构差异(联合图像-文本训练目标)使矫正的收益相对小。
5.2 Precision / Recall:矫正同样在"提精度、降召回"
| 模型 | 设置 | FID ↓ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|
| DiT-XL/2 | 无引导基线 | 9.58 | 0.668 | 0.676 |
| 矫正采样 | 2.07 | 0.811 | 0.603 | |
| CFG 参考 | 2.51 | 0.818 | 0.581 | |
| SiT-XL/2 | 无引导基线 | 8.55 | 0.687 | 0.669 |
| 矫正采样 | 1.92 | 0.812 | 0.608 | |
| CFG 参考 | 2.11 | 0.820 | 0.595 | |
| SiT-REPA-XL/2 | 无引导基线 | 5.53 | 0.708 | 0.739 |
| 矫正采样 | 1.31 | 0.797 | 0.703 | |
| CFG 参考 | 1.35 | 0.803 | 0.699 | |
| JiT-L/16 | 无引导基线 | 14.86 | 0.607 | 0.672 |
| 矫正采样 | 2.96 | 0.766 | 0.601 | |
| CFG 参考 | 2.35 | 0.780 | 0.606 |
读法:矫正与 CFG 一样,都是用召回换精度(Precision 0.67→0.81,Recall 0.68→0.60)。也就是说,它们都在把分布往"更典型、更少样"的方向推。
区别在于程度与观感:矫正的 Recall 通常略高于同档 CFG(例如 SiT-REPA 0.703 vs 0.699),且色彩不过饱和;论文用 husky 对比与人类偏好研究来支撑这一点。
5.3 文生图(NanoGen)
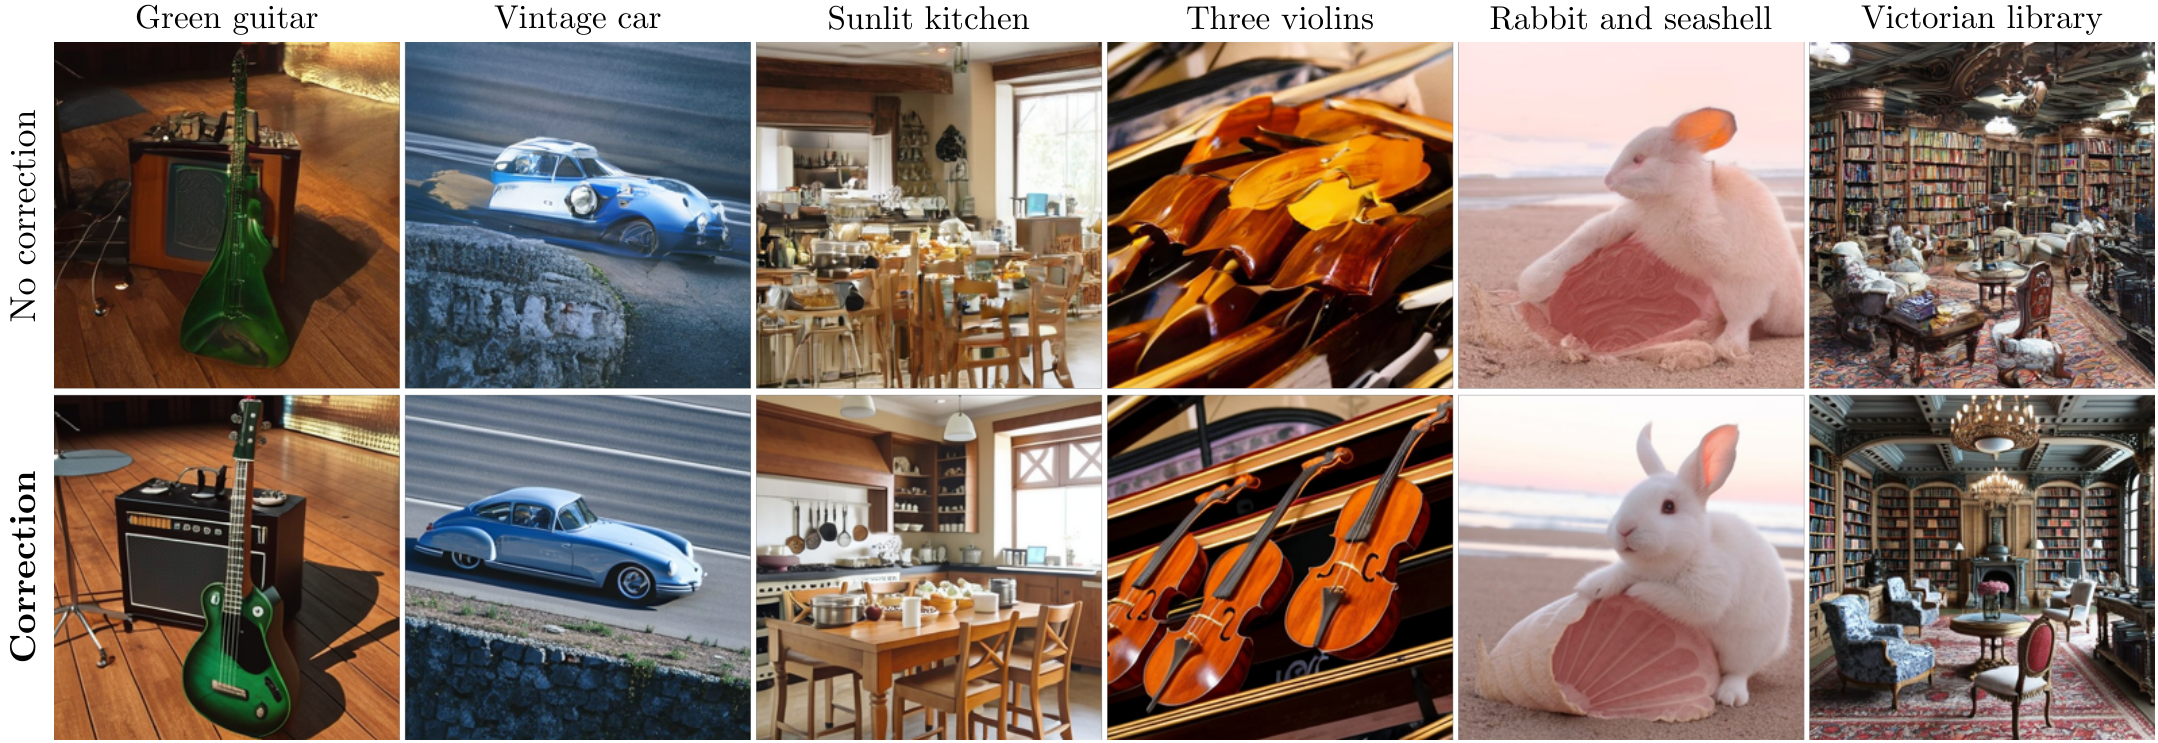
基座在 BLIP-3o 的 Short-Caption、Long-Caption、JourneyDB 子集上预训练(共约 3,600 万图文对)。矫正同样显著改善样本,物体结构更干净。
提示词对齐(GenEval / DPG-Bench)
| 设置 | K | 网络评估 | GenEval ↑ | DPG-Bench ↑ |
|---|---|---|---|---|
| 无 CFG | 0 | 250 | 28.30 | 70.71 |
| 无 CFG + 矫正 | 6 | 245 | 50.09 | 76.82 |
| CFG (w = 4) | 0 | 250 | 68.08 | 83.38 |
| CFG + 矫正 (w = 4) | 2 | 246 | 70.48 | 83.69 |
最有分量的一行是第二行:无 CFG + 矫正把 GenEval 从 28.30 拉到 50.09——几乎翻倍,而且这是在没有任何引导的情况下。
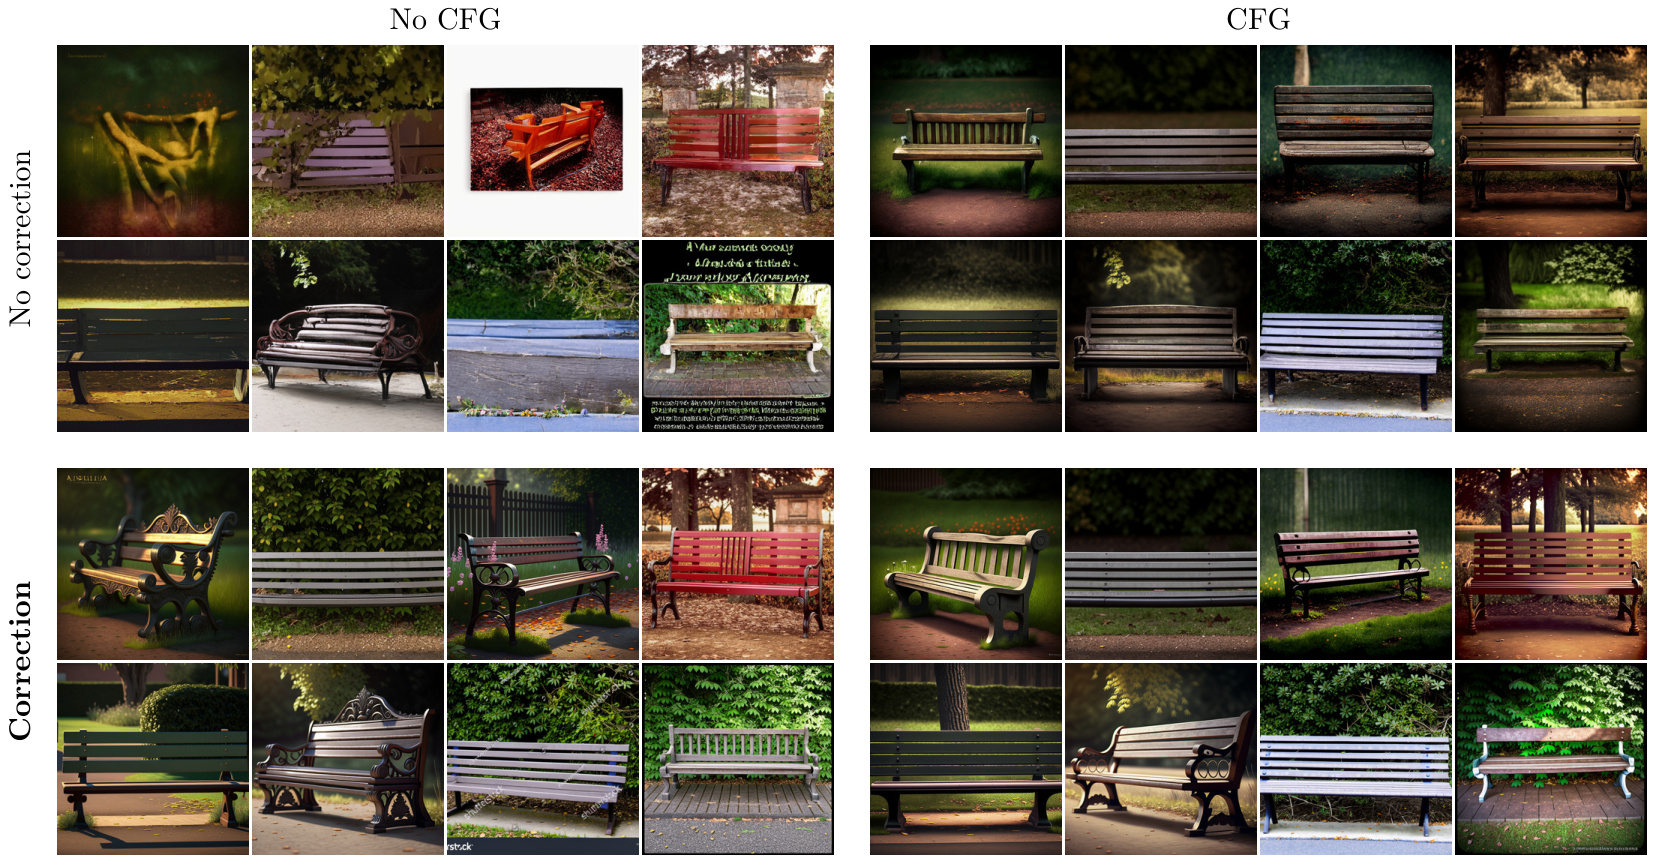
人类偏好研究
跨 80 个 GenEval 单物体 prompt、每准则每 prompt 10 次判断(共 800 票/准则,1,600 票),通过 Rapidata 收集。基线为 DiffusionBench 默认 CFG 尺度的 CFG-only:
| 准则 | CFG + 矫正 | 仅 CFG |
|---|---|---|
| 质量 | 60.75% | 39.25% |
| 多样性 | 60.25% | 39.75% |
5.4 额外推理成本可以被蒸馏掉
矫正的代价是每个去噪步多 K 次前向。论文的收尾是把精修后的预测蒸馏回基座扩散模型,从而在不增加推理开销的前提下保留质量收益。
矫正训练充当了生成"更好监督信号"的机制:先用矫正器把每个去噪步的目标修好,再让基座模型去拟合这些修好的目标。训练成本一次性付出,推理零开销。
06 — 对比
既然能比肩 CFG,为什么不直接用 CFG?
CFG 的两个顽疾
- 模式坍缩:同一文本提示下,生成结果在布局、姿态、风格上趋于雷同、乏味。
- 过饱和:色彩被推得过度浓艳,这是许多文生图模型"AI 味"的主要来源。
矫正的两个对应优势
- 保留多样性:同类别、同初始噪声下,矫正保留更多样的姿态、取景与背景。
- 更自然的色彩:避免 CFG 把饱和度推到极端。
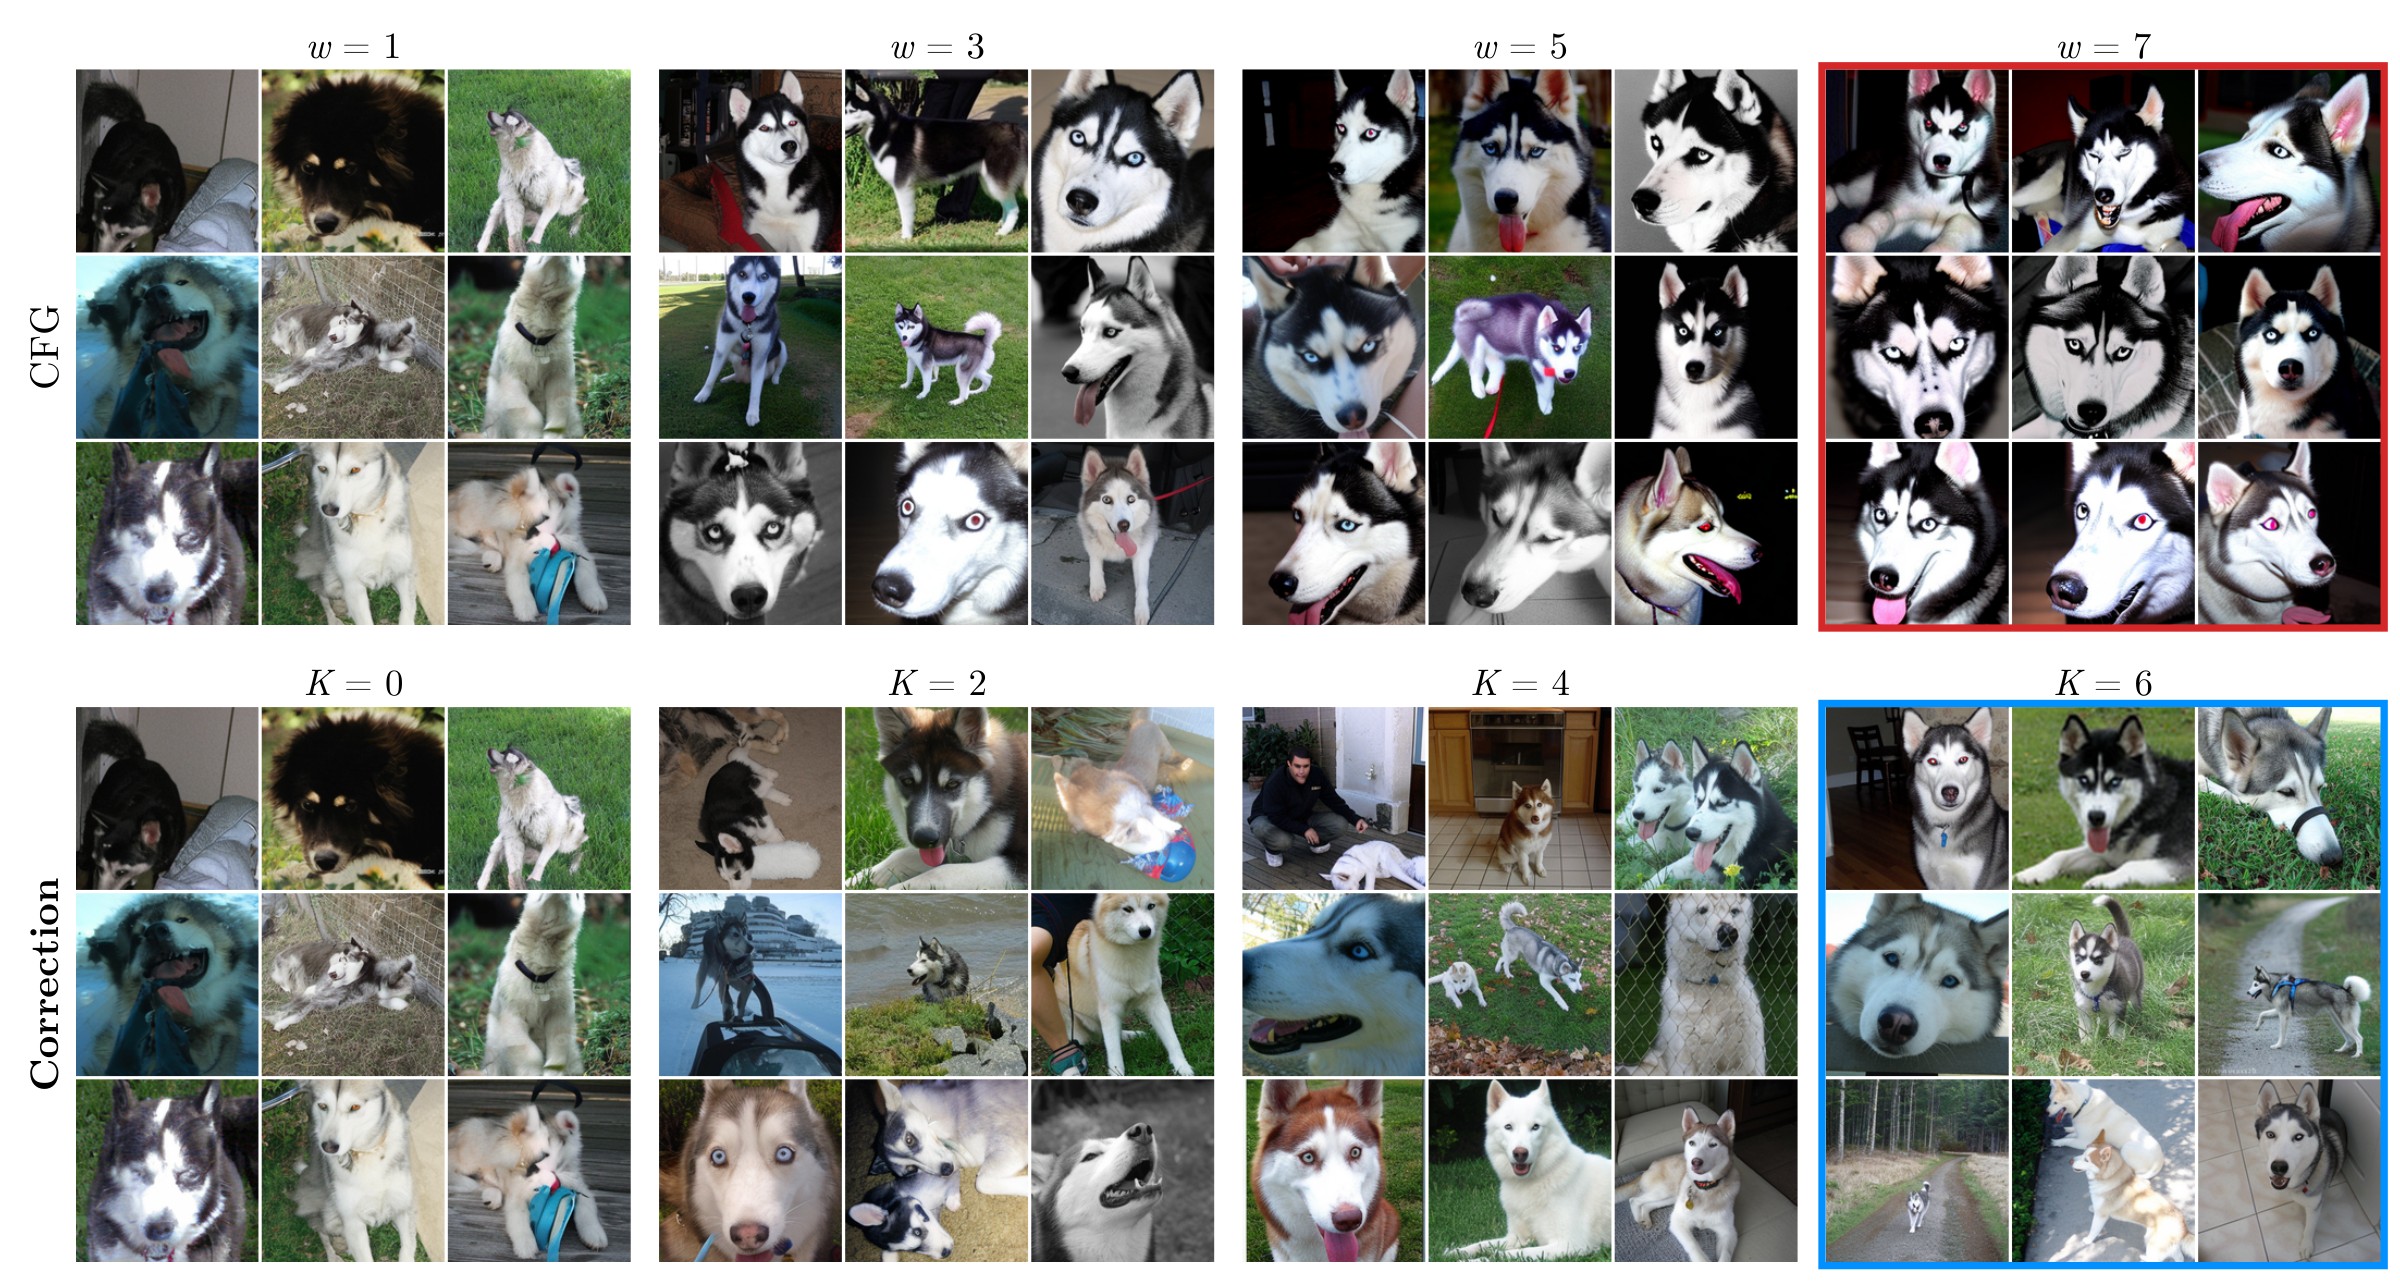
矫正可以和 CFG 叠加:把矫正作用于 CFG 的预测上,可以减少 CFG 带来的"AI 味"、过饱和与多样性损失。同时仍可以通过调节 CFG 尺度来控制"多样性 vs 提示词遵从"的取舍。矫正后的样本无论有无 CFG,都比对应基线更好。
07 — 批判性评估
哪些站得住,哪些要存疑
站得很稳
- 同算力消融三层递进,非常有力:K=1 打平单体去噪器(排除"拆分本身有用")→ K=3 大胜(排除"只是多花算力")→ 半参数 D7+C7 仍胜(排除"参数量")。这个实验设计值得照抄。
- 分类器双样本检验把抽象的"训练—推理差距"变成可测量量(AUROC/BCE,按噪声水平分层),且随 K 单调缩小——机制证据链完整。
- Ktrain 消融是全文最有趣的发现:最优推理 K ≈ 2×Ktrain,且最佳 FID 恰好落在训练误差高于基线的区间(Figure 16)。
- 权重共享与蒸馏都有数据:共享主干几乎不掉点(0.68B 达 2.14);蒸馏省 67% NFE。
- 跨架构一致:DiT、SiT、SiT-REPA、JiT 全部大幅改善,且 ImageNet checkpoints 已发布。
- 诚实的负面数据点:JiT 上矫正(2.96)不如 CFG(2.35),论文照实报告。
- 承认局限:结论一节明确写"theoretical understanding of its effectiveness and iterative behavior remains an open question"。
要打折看
- "缩小差距"的解释是假设性的。论文原话是 "We hypothesize that correction may improve generation by bringing these states closer to the training distribution"——分类器检验支持这个假设,但并没有建立因果。
- K 的最优值依赖任务且没有准则:ImageNet 用 K=8,文生图 CFG 情形只用 K=2,同算力消融用 K=3。而且 Ktrain 消融显示最优 K 会随训练设置移动。
- 矫正器会增加训练成本:多一个网络、每个训练步多一次前向+反向,还可能共享主干导致梯度冲突。相对蒸馏管线仍是省的,但论文没有量化训练开销。
- JiT 上不敌 CFG:说明方法并非在所有架构上都能"替代"CFG,只能"替代大部分"。
- 过度矫正是真实风险:Figure 13(b) 显示 K 过大时会出现"过度规则的几何形状"(圆盘状配料、网格状草莓籽)。这与"更锐利连贯"是同一机制的两面。
- 冻结去噪器在高 K 下会退化并出现过饱和——如果你只有别人的 checkpoint 而不能联合训练,要格外小心 K。
证据空缺
- 文生图代码尚未发布(仓库标注 "coming soon"),只有 ImageNet checkpoints 可下载。
- "暴露偏差"的因果链仍不完全闭合:缩小差距与提升质量之间的联系是相关性 + 机制假设,不是受控因果证明。
- 矫正器架构选择未讨论:corrector 是与去噪器同构还是更小?深度如何定?论文只在消融里用了"一半层数"这一个设置。
- 过度矫正只有定性描述:Figure 13(b) 展示了"过度规则的几何形状",但没有给出量化准则(如何判断当前 K 已经过度?)或自动停止机制。
- 与其它"弥合差距"方法未正面对比:如 Input Perturbation、MixFlow、DEFAR 等同类思路只在引言提及,没有实验比较。
值得追问的技术问题
- 为什么迭代使用有效,而单次使用无效?论文观察到这个现象但机制解释只到"缩小差距"。一个可能的更深解释:矫正器学到的映射在预测流形上是一个收缩算子,单次只走一小步,K 次才走到数据流形附近——这与不动点迭代的框架很像。但论文没有往这个方向形式化。
- K 与去噪步数的关系是什么?文生图 CFG 情形 K=2、ImageNet K=8、同算力消融 K=3。是否存在一个"总矫正算力 vs 去噪步数"的最优分配律?论文未给出。
- 矫正器会不会学成"恒等映射"?如果去噪器已经很好,矫正器的最优解接近恒等。训练时如何避免它坍缩到恒等(那样就没用了)?论文未讨论。
- stop-gradient 的必要性?如果去掉 stop-gradient,矫正损失会训练去噪器——会出现什么样的失败?这是一个很容易做的消融,但论文没报告。
- 与上一代"蒸馏修复"方法的关系?论文结尾提到把精修预测蒸馏回基座。这与"用更好的目标训练"在概念上接近 REPA 一类表示对齐方法。它们之间的关系值得梳理。
- 不同噪声水平上 K 应该不同吗?低噪声时结构已定,矫正主要加细节;高噪声时矫正能改结构。自适应 K(按 t 调度)可能更优,但论文用的是固定 K。
- 为什么"外推到训练监督之外"是有益的而不是有害的?这是 Ktrain 消融留下的最大问号。论文给的解释是"监督更多步只是把同一个修正摊到更多步上",但这是一个类比而非机制。若能找到预测"当前 K 是否已过度"的在线信号,就能把 K 从超参数变成自适应量。
- 过度矫正的边界在哪里?Figure 13(b) 的"过度规则几何形状"提示矫正器在放大某种"结构规律性"。能否用这个信号(比如局部自相似度)作为停止准则?
这是一篇方法极简、实验扎实、机制论证有分寸的论文。它最硬的两块是同算力消融(排除参数解释)和分类器双样本检验(把机制变成可测量)。它最弱的地方是因果解释仍停在假设层面,以及 K 的选择缺乏准则。
实用价值很高:如果你在做一个无 CFG 就出不了好图的扩散模型,这是一个训练期改动、可用蒸馏消除推理开销的方案,而且 checkpoints 已经放出来了(DiT / SiT / SiT-REPA / JiT)。
08 — 可用性
对你的研究有什么用
✓ 高度相关
- 如果你在做 3D 医学影像生成:医学影像恰恰是"没有 CFG 也能出好图"需求最强的场景之一——因为 CFG 的过饱和与模式坍缩在医学上意味着假病灶或同质化。矫正训练提供了一个不用 CFG 的替代路径。
- 与你已读的三篇构成一条完整的方法谱系:GT(训练期配对)、Velocity Scaling(推理期增益)、这篇(训练期加矫正网络 + 推理期迭代)。三者都在解决同一个问题——采样误差累积 / 训练-推理差距,只是切入点不同。
- 可复现成本低:ImageNet checkpoints 已发布,且方法只需在已有训练管线上加一个矫正头。
- 提供了可测量的诊断工具:分类器双样本检验(AUROC)可以直接搬到你的管线上,量化你自己的训练-推理差距。
△ 需要注意
- 全部实验是 2D 图像(ImageNet 256、文生图 256)。3D 体数据上矫正器的设计与成本都未验证。
- 矫正器会增加显存:3D UNet/DiT 本身已接近显存上限,再加一个矫正网络(即使只有一半层数)可能放不下。
- 医学影像的"误差累积"表现不同:自然图像的误差累积是美学/结构问题;医学影像的误差累积可能表现为假阳性病灶或解剖不一致——这是更严重但未被论文讨论的情形。
- K 的调参成本:每个任务都要扫 K,而 3D 采样昂贵。
- 先测差距,不要先加矫正器。用论文的分类器双样本检验,量化你现有 3D 生成器的训练-推理差距(AUROC 随 t 的曲线)。如果差距小,这条路不值得走。
- 用最小的矫正器。论文的消融用的是"一半层数"。建议从更小开始(如 1/4),因为 3D 模型的显存预算紧张。
- 固定算力比较:严格按论文的对照设计——"更深网络 vs 拆两半 + 矫正 K 次",保证层评估总数一致。这是这篇论文最有说服力的实验设计,值得照抄。
- 医学专属评估:除了 FID,务必加入解剖一致性指标与假病灶率。矫正降低 FID 的同时是否引入了临床上不可接受的变化,是真正的风险点。
- 检查 stop-gradient 的必要性:这是论文缺失的消融,也是你最容易做出的增量贡献。
- 训练时多监督几步矫正:Ktrain 消融显示,监督 2–4 步能把可用的推理 K 推到更大、最优 FID 相当。这样给你后续调 K 留出更大的安全区。
- 警惕过度矫正:K 过大时样本会出现"过度规则的结构"并偏离真实分布(论文 Figure 13b)。建议同时监控矫正后的去噪误差(式 7)——它开始高于基线时,你大概率已越过最优点。
它们其实在解决同一个问题:扩散/流模型的采样误差累积。
- Global Transport(arXiv 2610.07555):从训练期配对入手,让轨迹更直、更容易少步积分。
- Velocity Scaling(arXiv 2610.10823):从推理期增益入手,用"群体时间滞后"解释增益的作用。
- Correction Training(本篇):从训练期加网络 + 推理期迭代入手,显式地修每个去噪步的预测。
三者可以叠加。而且这篇论文的分类器双样本检验,恰好是 Velocity Scaling 那篇"群体时间滞后"探针的对偶工具——前者测"状态来自训练还是采样",后者测"状态相当于哪个时刻"。两个探针合起来可以很完整地刻画你自己的训练-推理差距。
09 — 速查
一页带走
核心公式
| 内容 | 公式 | 作用 |
|---|---|---|
| 插值路径 | zt = (1−t)x + tε, t∈[0,1] | t=0 是数据、t=1 是噪声(式 1) |
| 去噪损失 | ℒdenoise = 𝔼‖Dθ(zt,t) − x‖² | 原封不动(式 2) |
| Euler 步 | zs = (s/t)zt + (1 − s/t)·x̂⁽⁰⁾ | 用预测构造下一步输入(式 3) |
| 矫正损失 | ℒcorr = 𝔼‖Cφ( sg[x̂⁽⁰⁾], t ) − x‖² | 同一目标、stop-gradient(式 4) |
| 联合训练 | ℒtotal = ℒdenoise + λcorrℒcorr | 两项联合、矫正器输入在线生成 |
| 采样(每步) | x̂⁽⁰⁾ = Dθ(zt,t); x̂⁽ᵏ⁺¹⁾ = Cφ(x̂⁽ᵏ⁾, t),k=0…K−1 | 同一噪声水平上迭代 K 次(式 5) |
| 矫正后误差 | ℒ(k)denoise = 𝔼‖x̂⁽ᵏ⁾ − x‖² | k≥3 时高于基线(Figure 14) |
| 蒸馏 | ℒdistill = w(t)‖Dθ′(zt,t) − x̂(k*)‖²,w(t)=1/t² | 把矫正收益塞回基座,省 67% NFE(式 6) |
| 关键规律 | 最优 K ≈ 2 × Ktrain | 收益来自「外推到训练监督之外」 |
关键数据
| 数字 | 含义 |
|---|---|
| 2.07 / 1.92 / 1.31 / 2.96 | DiT / SiT / SiT-REPA / JiT 的无引导 FID(矫正训练) |
| 9.58 / 8.55 / 5.53 / 14.86 | 对应的基线(无引导)FID |
| 2.51 / 2.11 / 1.35 / 2.35 | 对应的 CFG 参考 FID |
| 5.66 vs 8.93 | 同算力下"矫正 3 次" vs "28 层去噪器" |
| 28.30 → 50.09 | 文生图无 CFG 的 GenEval(矫正前后) |
| 60.75% / 60.25% | 人类偏好研究中矫正获选比例(质量/多样性) |
| K = 2 ~ 8 | 常见矫正次数(任务相关) |
术语
| 术语 | 含义 |
|---|---|
| Corrector C_φ | 矫正网络。输入去噪器预测,输出去噪后的干净预测。与去噪器共享同一干净目标训练。 |
| Exposure bias | 暴露偏差。训练时输入来自真实数据,推理时输入来自模型自身预测,导致误差累积。 |
| Training–inference gap | 训练—推理差距。即上面那个偏差造成的分布差异。本篇用分类器 AUROC 来量化它。 |
| stop-gradient (sg) | 阻断梯度回传。这里用于让矫正损失不影响去噪器参数。 |
| K | 每个去噪步内重复矫正的次数。K > 1 才有效,通常 2–8。 |
| Classifier two-sample test | 分类器双样本检验。训练一个分类器判断样本来自哪个分布;AUROC=0.5 表示不可区分。 |
| REPA | 表示对齐方法,通过让 SiT 隐层对齐预训练视觉编码器特征来加速训练。SiT-REPA 是本篇最强基线。 |
| GenEval / DPG-Bench | 文生图的提示词遵从 / 语义对齐基准。 |
自己上手
- ImageNet checkpoints 已可下载:jit、sit、sit-repa-50k、sit-repa-100k(含 config.json + model.safetensors,自动校验、支持断点续传)。
- 采样与训练代码尚未发布(仓库标注 coming soon);文生图实现也不在本次预览中。
- 最小改动路径:在现有训练脚本里加一个矫正头 + 一条矫正损失(注意 stop-gradient),采样循环里加一个 K 层内循环。
- 评估建议:除了 FID,务必同时报告 precision/recall 与多样性指标——矫正的价值恰恰在"质量与多样性兼得",只报 FID 会低估它的优势。