Feature Information Dynamics · 论文精读把「特征何时被生成」变成可测量的量
Feature Information Dynamics in Diffusion
Jia-Shu Pan, Tao Zhang, Yufei Huang, Yanjun Sheng, Tailin Wu
西湖大学 · 浙江大学 · 澳大利亚国立大学
一句话:用信息论里的 I-MMSE 恒等式,把"某个特征(类别、频率带、语义、边缘)在扩散轨迹的哪个噪声水平上被生成"从一句定性直觉,变成一条可积分的曲线。 顺带定量确认了"像素扩散 ≈ 谱自回归",并发现一个意外结论:像素空间里,结构信息比类别信息进入得更早。
01 — 30 秒速览
这篇论文做了什么
"扩散模型先出粗结构、后出细节"是人人都会说的直觉。但它一直是定性、经验性的。这篇论文给出一个通用、定量的框架来回答:某个特征到底在扩散轨迹的哪个位置被"生成"?
① 特征信息密度
用 I-MMSE 恒等式,把「特征 Y 与含噪图像之间的互信息如何随 SNR 变化」接到最优无条件去噪损失与特征条件去噪损失之差上。这样就能用训练好的去噪器直接估计。
② 链式分解
当有多个相关特征(比如类别 → 掩码 → 边缘)时,单独算每个特征会重复计入共享信息。链式分解把每个特征的贡献定义成"在前一个特征束之外的增量"。
③ 表征是可调旋钮
同一条件链、同一数据,在 pixel / SDVAE / VAVAE / RAE 四种表征下给出性质不同的信息动力学。只有 RAE 做出干净的语义 → 结构 → 局部 顺序。
④ 定量确认谱自回归
在像素扩散上定量验证了"低频先于高频"——但前提是先做链式分解。不做链式分解,各频带曲线会严重重叠,看不到清晰顺序。
⑤ 一个意外发现
像素扩散里 mask 信息比类别信息进入得更早、更强。这挑战了"先语义后细节"的简单叙事。
⑥ 表征选择 = 可控旋钮
表征的差异在 FID 上是黑箱,在信息动力学曲线上却是可见的形状差异。这把"选哪种表征"从经验问题变成了可诊断的问题。
它与本系列前三篇正好互补:GT、Velocity Scaling、Correction Training 都在改方法(配对、增益、矫正网络),而这篇在造测量工具。它不提升 FID,但给你一把尺子,去量"你的扩散模型到底在哪个噪声水平学到了什么"。而且这篇恰好给前三篇里的许多现象(谱自回归、暴露偏差、表征带来的训练速度差异)提供了一个统一的测量框架。
02 — 方法
从高斯信道到特征信息密度
2.1 高斯信道与 MMSE
设干净数据 X ∈ ℝ^d ~ p(x),感兴趣的特征 Y ~ p(y|x)(可以是类别标签,也可以是某个频率分量)。考虑加性高斯信道:
其中 γ ≥ 0 是信噪比。在平方误差下,能从 (Xγ, 侧信息 S) 去噪 X 的最小误差就是最小均方误差 MMSE,其最优解是条件期望:
论文主要用两个实例:无条件 MMSE 与特征条件 MMSE:
由于最优无条件去噪器本身就是一个"忽略 Y"的(可能次优的)特征条件去噪器,所以恒有:
两者的差衡量"特征 Y 在这个 SNR 上帮了多少忙",作者称之为单特征 MMSE 差距:
2.2 I-MMSE 恒等式与特征信息密度
经典 I-MMSE 恒等式(Guo 等,2005)说的是,对上述高斯信道:
同样的论证在给定 Y 的条件下也成立:
而信道输出 Xγ 只通过 X 依赖 Y,所以给定 X 时 Xγ 与 Y 条件独立,即 I(Y; Xγ | X) = 0。互信息链式法则因此给出:
移项后对 γ 求导,就得到这篇论文的核心量:
特征信息密度 DY(γ):它量化"特征 Y 携带的信息如何沿 SNR 轴分布"。把它沿 γ 积分就回到标量恒等式 I(Y;X) = ∫DY(γ)dγ。
关键在于:右边是两个去噪损失之差——这是可以用训练好的神经网络估计的东西。于是"什么时候学到了什么"从哲学问题变成了回归问题。
实际使用时常把 SNR 轴换成对数 SNR 轴 t = log γ,这样能平衡跨越许多个数量级的贡献:
2.3 落到扩散 / 流匹配上
作者用高斯流匹配(独立耦合、线性插值)实例化:
由 Xt/(1−t) = N + √γ(t)·X 可得 γ(t) = (t/(1−t))²。最优流匹配速度预测器与最优去噪器之间的线性关系,把 MMSE(x-预测损失)等价地变换成标准的流匹配训练目标:
关键含义:单特征 MMSE 差距可以直接从"最优无条件流匹配损失"与"最优特征条件流匹配损失"之差得到,完全不需要改训练目标。
2.4 实际估计器与一个陷阱
给定训练好的无条件与特征条件去噪器,用 Monte Carlo 在测试样本上估计 Δ̂Y(γ) 即可。论文在附录 A 还推导并比较了四种等价形式:后验均值、Fisher、score-difference、likelihood-score。
原始的 MMSE 差距只在有限 SNR 范围内可靠。在高 SNR 端,去噪误差很小、梯度很弱,有限容量的去噪器会欠拟合干净数据极限——导致经验 MMSE 被高估,直接数值积分可能偏高甚至不收敛。
作者的解决办法:在可靠区间内,用一个平滑的双极点 Lorentzian 族 L(γ) = a/(1+bγ)² 拟合单特征 MMSE 差距,再解析地外推尾部。这个简单拟合与经验差距吻合得意外地好(附录 B)。
03 — 链式分解
把共享信息从增量信息里剥出来
单个特征的密度有个问题:当多个特征相关时(比如频率带之间、类别与掩码之间),单独计算会重复计入共享信息。这是谱实验里最先暴露出来的坑。
解决办法是把前 k 个特征捆成一个累积束,构造一个嵌套的条件束序列:
例如 𝒴≤1 = 类别,𝒴≤2 = (类别, 掩码),𝒴≤3 = (类别, 掩码, Canny)。记 mk(γ) = mmseX|Xγ,𝒴≤k(γ),则第 k 层的链式信息密度定义为 𝒴≤k 相对 𝒴≤k−1 的增量信息:
方括号里的差称为链式 MMSE 差距 Δchaink(γ) := mk−1(γ) − mk(γ)。与 3.2 节相同,沿 log γ 积分就得到对应的条件信息增量。
峰的位置和宽度就是答案
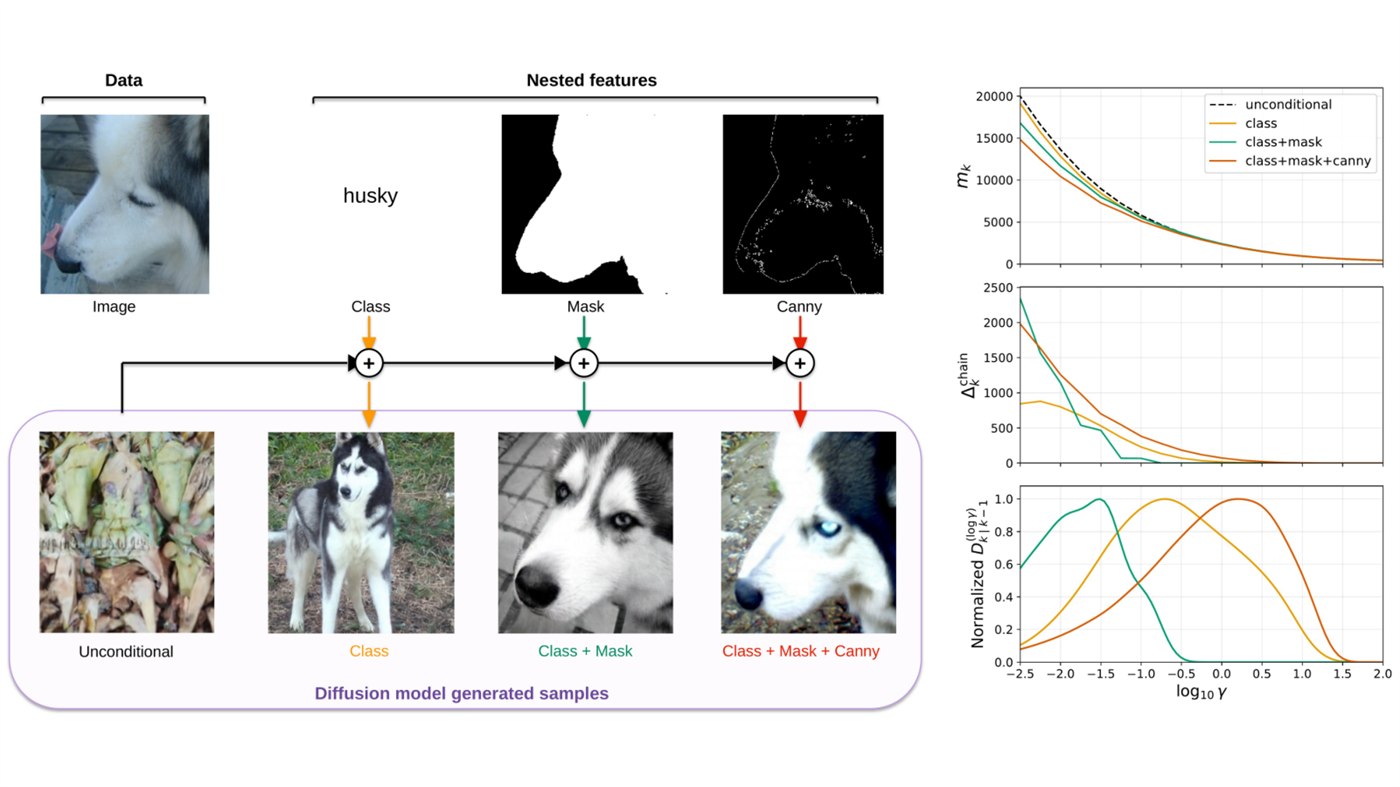
论文的核心操作是:在每个 SNR γ 上,比较一个无条件去噪器与一系列条件越来越丰富的去噪器。链式 MMSE 差距把这些去噪损失的差,转换成沿 log-SNR 轴的逐层信息密度。
每条 D(log γ)k|k−1 的峰值位置与宽度就定位了"对应特征在扩散轨迹上何时最有信息量";这些峰的排列顺序则是所选表征如何组织其特征信息动力学的经验签名。
链式归因依赖所选的特征顺序——因为每个增量都以前面那束特征为条件。它不是一个与顺序无关的信息分配。作者用 类 → 掩码 → Canny 作为"语义到局部"的规范顺序,并在 Limitations 与 Table 1 里检验了这个选择的影响。
04 — 实验 I
定量确认:像素扩散 ≈ 谱自回归
像素扩散常被描述为"由粗到细"。更精确的版本是谱自回归:低空间频率先于高空间频率被解析。而要定量检验它,必须先把"各频带共享的信息"与"每个频带的增量信息"分开。
4.1 为什么必须链式:MNIST 上的对照
作者在受控的 MNIST 频率层级上做了对照:把每张图分解成从粗到细的有序频带 Y₀…Y_K,比较两种分解方式——单频带(每个频带独立作为条件)与前向链式(条件是累积束 𝒴≤k)。
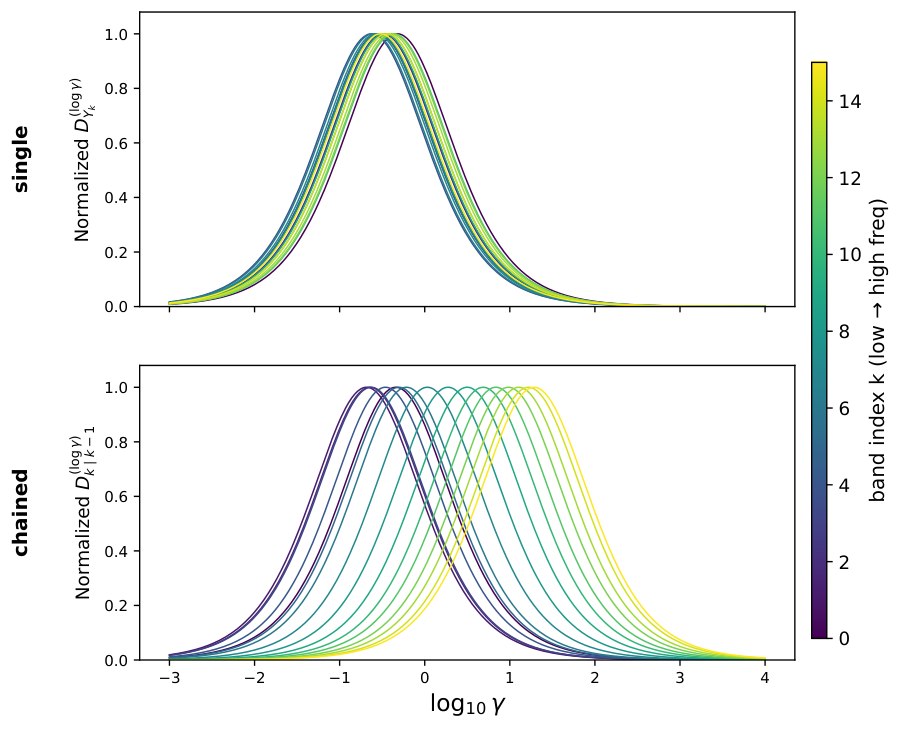
同一些频带、同一些数据,仅仅换一种条件构造方式,结论就从"看不清"变成"看得很清楚"。这证明了链式分解不是可有可无的修正,而是必要的步骤。
4.2 CIFAR-10:单调的谱推进
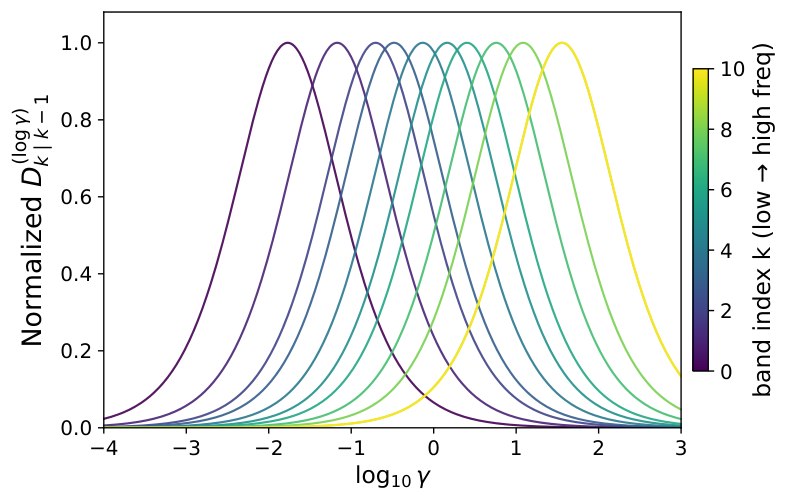
结论(定量版):像素扩散确实近似遵循谱自回归——特征信息密度不仅告诉我们"粗频率先于细频率",还告诉我们每个增量频带在 SNR 轴上的哪个位置被解析。
05 — 实验 II
表征重塑特征信息动力学
谱实验只覆盖了频率。真正有意思的问题是:语义、结构、纹理这些信息,在现代图像扩散模型里是怎么被生成的?以及——换一种隐空间表征,会不会改变它们的生成顺序?
5.1 一个一般视觉特征层级
作者构造了一条三级的条件链,每一级对应视觉层级的一层:
- 类别标签(class)— 全局语义,高层
- 分割掩码(mask)— 物体级空间支撑,中层
- Canny 边缘(Canny)— 局部边界结构,低层
数据:SAM 3.1 校验过的 ImageNet-256 子集——对每个类别跑 SAM 3.1,只保留掩码成功率 > 95% 的类(485 类);Canny 边缘在掩码内计算。配对的 {图像, 类别, 掩码, Canny} 数据集在四种表征之间逐字共享。
5.2 训练速度测试(同配方)
在此之前,跨表征的训练速度比较大多基于发表过的 FID 曲线,但那些曲线在生成器架构与训练配方(优化器、时间偏移调度、采样器、学习率 warmup、FID 样本数)上都不同,无法归因。
作者设计了一个只变表征的训练速度测试:把对早期 FID 影响最大的配方变量(训练噪声偏移 αt、采样噪声偏移 αs、学习率)先在小的 LDiT-B 上用固定网格选好,再冻结到所有四条 XL 轨迹上。四者共享 256 个 token、同一个 LDiT-XL、同一个采样器(Euler,50 NFE,无条件推理)。
最慢。200 epoch 最佳 FID 78.51(ep.200)。收敛曲线在整个预算内都明显落后。
FID 30.83(ep.200)。重建驱动的连续 VAE 隐空间。
FID 21.16(ep.200)。在 VAE 隐空间上加了视觉基础模型对齐。
最快。FID 8.39(ep.180 即达)。直接建立在 DINOv2 特征上的表征自编码器。
排序对我们显式控制的配方变量是鲁棒的,也与 VAVAE、RAE 原论文的定性排名一致。
但它不解释机制:"为什么某种表征会让扩散训练更容易或更难"在匹配优化配方下仍是一个开放问题。这正是下一节要用信息动力学诊断的东西。
5.3 逐表征的信息动力学诊断
现在把链式特征信息动力学连同"类 → 掩码 → Canny"的层级先验,作为上面收敛速度排序的诊断工具。每个表征的条件阶段都从对应骨干的公开预训练 checkpoint 初始化,再按官方流水线微调新条件——这样每个 mk(γ) 都是在该空间可达的最佳扩散损失/MMSE 下限附近评估,而不是早期训练的次优值。
结果:同一个条件链在不同表征上产生性质不同的信息动力学,而且这些差异与 5.2.1 的收敛速度排序是吻合的。
颠倒了经典层级。mask 密度的峰在比 class 密度更低的 log-SNR 上——mask 信息比类别信息进入得更早、更强。像素扩散并没有"先解析语义"。
恢复了"语义优先"的一半:类别增量的峰移到了比掩码峰更低的 log-SNR,被优先处理。但 mask 与 Canny 仍沿 log γ 相互重叠,没有干净地分开。
唯一实现严格 类 → 掩码 → Canny 顺序的表征。三条密度峰沿 log-SNR 轴落在教科书式的高 → 中 → 低顺序上,与经典视觉层级吻合。
"我们观察到:一个表征把它的特征密度层级组织得多干净,与它的扩散模型收敛多快之间存在相关性——但并不声称这个顺序导致了更快收敛。"
这个措辞很重要:是相关性,不是因果。而且作者在 §6.2 里明确说了这是描述性诊断。
「表征选择是对特征信息动力学的一个可控旋钮:同一个条件链、同一批图像和掩码,会给出表征特有的顺序——而这些差异从 FID 上是看不见的。」
06 — 批判性评估
哪些站得住,哪些要存疑
站得很稳
- 理论推导干净且自洽:从 I-MMSE 到特征信息密度只用了链式法则 + 条件独立性,没有额外假设。四种等价估计器(附录 A)互相印证。
- 链式分解的必要性被自己证明了:MNIST 上单频带 vs 链式的对照(图 2a),把"为什么必须这么做"变成了可视证据。
- 同配方训练速度测试:把配方变量先在小模型上选好再冻结,这是此前跨表征比较都没做的。仅这一项就比很多"谁的 FID 低"的比较更有价值。
- Limitations 写得非常诚实:明确列出两条"对解释经验曲线尤其关键"的局限并逐条检验(模型大小、checkpoint、链序),还说了"不建立因果机制"。
- 把表征差异从黑箱变成可观察的形状:这是真正的增量——以前只能看 FID 曲线,现在能看"哪层信息在哪个 SNR 进入"。
要打折看
- 用训练好的去噪器近似 Bayes 最优 MMSE。测得的差距既包含"信息"也包含"优化质量"。作者做了模型大小(132M vs 842M)与 checkpoint 检查来缓解,但这是近似,不是上界。
- 链式归因依赖特征顺序。换成 掩码→类别→Canny 会移动类别与掩码的峰(虽然在 RAE 上保住了分离度)。所以"顺序"这个结论是相对于所选顺序的,不是绝对的。
- 预训练初始化 vs 从头训练会给出不同结论(附录 D 自己记录了)。这意味着测得的"动力学"部分是训练历史的函数,不完全是数据的属性。
- "更干净的顺序 ⇔ 更快收敛"是相关性,只有四个数据点(四种表征)。作者没说因果,但读者很容易滑向"所以选 RAE 就好"的结论。
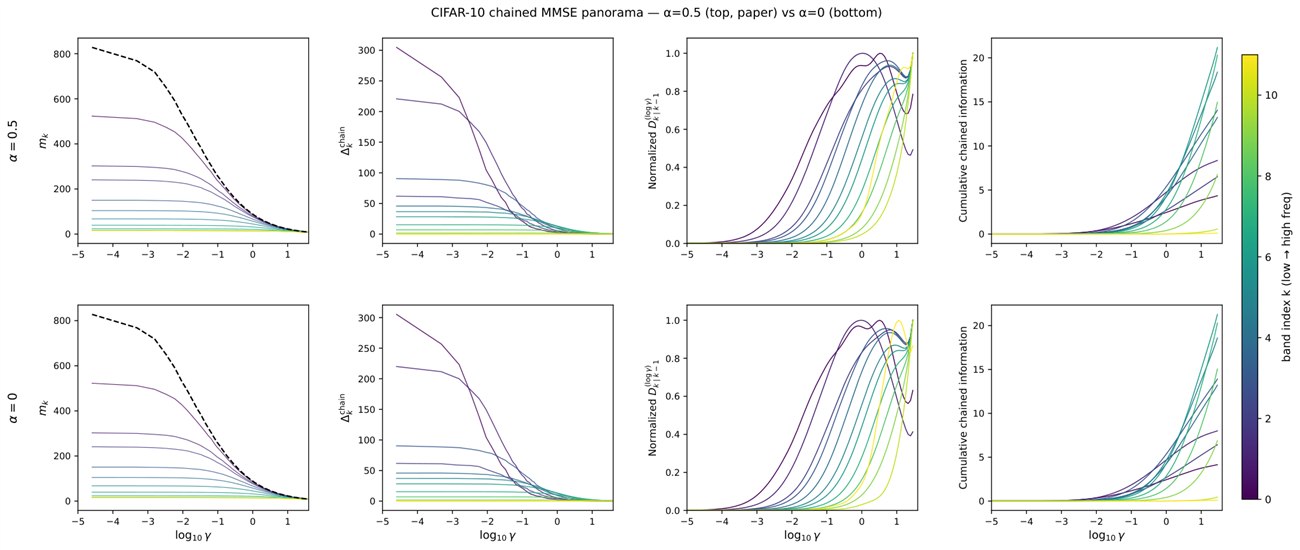
- 解析 Lorentzian 外推要求 α > 0:α=0 时某些高频带会退化(b 被钉在优化器下界),出现虚假峰(Table 3 标记了这处退化)。这限制了估计器的适用范围。
证据空缺
- 只有四个表征、一条条件链。计算预算限制了下结论的范围。没有覆盖例如 latent 一致性模型、离散 token 表征等。
- 互信息量是分布级平均。逐条曲线不必描述每张个体图像的行为——所以它不能告诉你"这一张图是不是也按这个顺序生成"。
- 加性高斯信道 + 独立耦合是前提。非独立端点耦合(例如某些流匹配变体)需要超出本文范围的扩展。
- 更大的层级需要更多累积条件模型——这是实际瓶颈:每个层级都要训一个条件去噪器,成本线性增长。
- 没有预测性验证:论文说"更干净的分离伴随更快收敛,因此这些曲线可作为表征选择的信号",但没有做一个"用曲线预测、再用训练验证"的前瞻性实验。所有结论都是事后解释。
- "像素空间 mask 先于 class"的机制未解释:为什么像素空间会颠倒层级?论文只报告了现象。这是最有意思的发现,却着墨最少。
值得追问的技术问题
- 峰的"位置"到底测的是什么?D(log γ)k|k−1 的峰在"该层信息进入最快"的 SNR 处。但"进入"是指可被条件识别,不是模型自己生成。用条件去噪器测出来的顺序,与无引导采样时模型实际生成顺序,是否一致?这两者概念上不同,论文有混用的倾向。
- 条件链会改变被测的动力学吗?链式分解把 𝒴≤k 作为条件。但条件本身可能改变去噪器的行为(例如给了掩码之后,模型对高频的处理方式可能变化)。这种"条件引起的动力学变化"与"特征本身的生成时机"如何区分?
- 像素空间为何颠倒了层级?这是最有意思的发现。一个可能的解释:像素空间中低频幅度远大于高频,SNR 由幅度主导,而 mask 这种粗空间结构恰好落在低频——所以它"先"进入更多是幅度/频率的几何而非语义的决策。但论文没有展开这个方向。
- 如果把链序反过来,会不会得到矛盾的信息总量?Table 1 显示换序后 RAE 上类别与掩码的峰仍分离。但在 pixel 或 SDVAE 上换序会不会出现"增量信息为负"或峰序完全重排?这能检验该诊断的稳健性边界。
- 能否把这个框架用于采样期干预?如果知道"mask 信息在 log γ ≈ −1 处进入",是否应该在该区间加大某类引导?论文在 §6.3 提了这个方向但没实验。
- 与 Correction Training 的关系?那篇论文说扩散模型有训练—推理差距(采样状态偏离训练分布)。如果不同特征在不同 SNR 进入,那么差距也可能是按特征分层的——某些特征层的采样状态偏离得更早。这两套测量工具结合可能给出按特征分层的差距诊断。
这是一篇工具型论文:它不提出新方法、不刷新 FID,而是给了扩散模型社区一把信息论尺子,把"什么时候学到了什么"从直觉变成曲线。它最硬的部分是理论推导的干净与链式分解必要性的自我证明;最弱的部分是结论被四点相关性撑着、且没有前瞻性验证。
它最大的潜在影响不是这篇本身,而是它打开的方向:如果你能测量"什么在什么时候被生成",你就能据此设计调度、条件顺序、甚至架构——这也是作者在 §6.3 列出的方向。
08 — 可用性
对你的研究有什么用
✓ 高度相关(作为诊断工具)
- 它是本系列四篇的"测量层"。GT 看耦合、Velocity Scaling 看增益、Correction Training 看矫正——三者都需要回答"我的模型在哪个噪声水平学到了什么"。这篇正好给了那把尺子。
- 解释了"表征选择影响训练速度"。这直接关系到你做 3D 医学影像时的隐空间选择(VAE? DINOv2 特征?):不同隐空间的信息动力学顺序不同,可能影响收敛速度。这篇给了你一个先诊断再选的方法。
- 可以按特征分层诊断训练-推理差距。Correction Training 用分类器测"状态来自训练还是采样";这个框架能进一步告诉你哪个特征层偏离得最早。两者结合是更强的诊断。
- 代码已开源,框架是表征无关的(只要能训练条件去噪器就能用)。
△ 成本与限制
- 每个层级都要训一个条件去噪器。三层链 = 三个额外模型。对 3D 医学影像(模型大、数据敏感)这是实际瓶颈。
- 需要特征可显式构造。类别、掩码、Canny 都容易;但"病灶形态"这类临床特征需要先定义成可计算的条件。
- 医学数据有额外约束:SAM 3.1 的掩码校验在医学影像上不一定可靠(不同模态差异大);且数据隐私限制跨中心共享。
- 结论是分布级的,对"这个病人的影像是否按正确顺序生成"没有保证——而后者才是临床关心的。
- 先做谱实验,不做语义实验。谱实验(MNIST/CIFAR 那套)便宜、受控,能先验证你的实现是否正确——论文的图 2 就是你应该复现的基准。
- 特征层级按你的任务定义。对 3D MRI,一个自然的链可能是:模态 → 解剖区域掩码 → 病灶分割 → 高频细节。这条链本身就是你研究里可解释的先验。
- 同时跑两个探针:这个框架的特征信息密度 + Correction Training 的分类器双样本检验。前者告诉你"什么在什么时候进入",后者告诉你"采样状态偏离训练分布多少"。合起来能定位哪个特征层的采样状态偏得最远。
- 不要急于把"顺序干净"当成选表征的标准。论文自己只观察到相关性。更稳妥的用法是:把曲线当作诊断输出,用于理解你的模型,而不是用于做选择。
- 最有价值的增量贡献:把"按特征的训练-推理差距"量化出来——这正是这篇与 Correction Training 两套工具的交集,且两篇都没做。
共同主题:扩散/流模型的采样过程不是黑箱,可以被测量、被诊断、被修正。
- Global Transport(2610.07555):训练期改耦合,让轨迹更直。
- Velocity Scaling(2610.10823):推理期加增益,用"群体时间滞后"解释。
- Correction Training(2610.correction):加矫正网络,显式修每个去噪步的预测。
- Feature Information Dynamics(本篇):测量层——不改变任何东西,但给你看清楚前三个到底改变了什么。
一个具体可行的组合:用本篇的特征信息密度,去量化 Correction Training 那个矫正器在不同特征层上的效果差异——矫正器是否对"晚进入的特征"更有效?这个问题两篇都没回答,但工具都是现成的。
09 — 速查
一页带走
核心公式
| 式 | 内容 | 作用 |
|---|---|---|
| (1) | Xγ = √γ·X + N | 高斯信道,γ 是信噪比 |
| (4) | m∅(γ), mY(γ) | 无条件 / 特征条件 MMSE |
| (6) | ΔY(γ) = m∅(γ) − mY(γ) ≥ 0 | 单特征 MMSE 差距 |
| (7) | d/dγ I(X;Xγ) = ½ m∅(γ) | 经典 I-MMSE 恒等式 |
| (11) | DY(γ) = ½ ΔY(γ) | 特征信息密度——全文核心量 |
| (13) | D(log γ) = γ·DY(γ) | 对数 SNR 轴上的密度(平衡各数量级) |
| (14) | Xt = (1−t)N + tX,γ(t) = (t/(1−t))² | 流匹配实例化 |
| (16) | m∅(γ(t)) = (1−t)²·min‖Vt−v̂‖² | MMSE 可从流匹配损失恢复 |
| (17) | D(log γ)k|k−1 = ½γ[mk−1−mk] | 链式信息密度——第 k 层的增量 |
| — | L(γ) = a/(1+bγ)² | 双极点 Lorentzian 外推尾部(要求 α>0) |
术语
| 术语 | 含义 |
|---|---|
| Feature information density | 特征信息密度 DY(γ)。特征 Y 与含噪图像之间互信息随 SNR 的变化率。 |
| I-MMSE identity | 互信息变化率与最小均方误差之间的关系(Guo-Shamai-Verdú 2005)。 |
| MMSE gap | 无条件与特征条件 MMSE 之差。衡量"这个特征在这个 SNR 上帮了多少"。 |
| Chained decomposition | 链式分解。把每个特征的贡献定义成"在前一个累积特征束之外的增量",避免重复计入共享信息。 |
| Spectral autoregression | 谱自回归。低空间频率先于高空间频率被解析的观点(Dieleman 2024)。本文给了定量版本。 |
| Occupation measure ν | (与本篇无直接关系,是上一上篇 Beckmann 里的概念,勿混淆) |
| SDVAE / VAVAE / RAE | 三种隐空间表征:重建驱动 VAE / VFM 对齐 VAE / 纯 DINOv2 特征自编码器。 |
| Classifier two-sample test | 分类器双样本检验(上一上篇 Correction Training 用的工具,与本篇的探针互为对偶) |
关键数字
| 8.39 | RAE 200 epoch 最佳 FID(最快收敛) |
| 78.51 | pixel 200 epoch 最佳 FID(最慢收敛,差 9.4 倍) |
| 485 类 | SAM 3.1 校验后保留的 ImageNet 类别数(掩码成功率 > 95%) |
| 4 种估计器 | 后验均值 / Fisher / score-difference / likelihood-score(附录 A) |
| α > 0 | 解析 Lorentzian 外推的要求;α=0 时高频带会退化 |
| 132M / 842M | 模型大小检查用的 RAE-S 与 DiTDH-XL(峰位置一致) |
自己上手
- 代码:github.com/AI4Science-WestlakeU/feature-information-dynamics
- 先复现谱实验(MNIST/CIFAR 频带),它受控、便宜,能验证你的实现正确。
- 务必做单频带 vs 链式的对照——不做链式分解,各频带会重叠,你看不出顺序。
- 检查可靠区间:原始 MMSE 差距在高 SNR 端不可靠,需要 Lorentzian 外推;同时注意 α 必须 > 0。
- 记住结论是相对于链序的:换特征顺序会移动峰位。报告时必须说明你用了什么顺序。