Global Transport · 论文精读无分类器引导流里的全局传输耦合
Global Transport Couplings for Classifier-Free Guided Flows
Katarina Petrović, Zander W. Blasingame, Danyal Rehman, İsmail İlkan Ceylan, Michael Bronstein,
Stephen Y. Zhang†, Lazar Atanackovic†, Alexander Tong†
AITHYRA · 牛津大学 · Mila · 蒙特利尔大学 · MIT · 维也纳工业大学 · Flatiron Institute · 阿尔伯塔大学
一句话:训练流匹配模型时,别管标签,直接对整批噪声和数据做一次全局最优传输配对(GT)。 这会让"无引导"的条件生成变差,但配上 CFG 之后,在所有领域、所有模型规模、所有采样预算上都变好—— 而且理论上它能缩小条件与无条件速度场之间的"预测差"。 这是一篇纯粹的生成模型训练技巧论文,与医学影像无关。
先回答你的问题
这篇论文对 3D 脑 MRI 生成有帮助吗?
先说事实:这篇论文一个字都没提医学影像。我全文检索过——medical、MRI、brain、3D、voxel、volumetric、radiolog、clinical、CT、PET、DWI 的出现次数全部为 0。它的实验只有三块:ImageNet-256 类条件图像、ImageNet-256 文本条件图像、以及单细胞基因表达。作者在"局限与未来工作"里还专门写了相反的话——"由于 CFG 主要用于图像和视频生成,把这些收益迁移到生命科学中细胞以外的领域,仍然是个开放问题"(transferring these gains to domains outside of cells in the life sciences ... remains open)。
所以如果你是把这篇当成"某篇脑 MRI 生成的新工作"来找的,那是认错论文了——标题里既没有 MRI 也没有医学,作者团队(AITHYRA / 牛津 / Mila)做的是最优传输与生成模型理论,唯一沾生物的地方是单细胞数据。
那"方法上能不能用"?分三层看
✓ 直接适用的部分
- 训练期技巧,零推理改动:只改"噪声↔数据怎么配对",不动网络、不动采样器、不动 CFG。3D MRI 生成器(无论用 flow matching 还是 diffusion)都能直接套。
- 条件连续/类别多时更省事:C2OT 需要"每个条件单独解一次 OT",对"多中心 + 多序列 + 多模态 + 年龄/病程等连续条件"根本不可行。GT 不求按条件分组,恰好绕开了这个瓶颈。
- 开销可忽略:O(B²) 显存、O(B³) 时间,实测只加 3.1% 每步耗时。你的算力瓶颈在 3D UNet/DiT 前向,不在配对。
△ 要打问号的部分
- 收益来源是"高引导区间"。GT 最大的价值是让 w 能推到很大而不崩(yo-yo 效应被抑制)。如果你本来就用低 w(而医学影像常为"保真/不虚构"而压低引导),GT 的增益可能大部分消失。
- 论文自己承认因果未证:预测差更小不等于生成更好。作者明确说这个界"只是用来启发图 3 的测量,本身不构成生成性能的解释"。
- 验证过的只有 2D 图像 + 1D 向量。没有任何体数据、没有 3D 卷积/patch 的实验。3D 的空间结构与 2D 不同,"配对"的语义也会变(见下文)。
✗ 可能不适用甚至有害的部分
- "无引导更差"这一点在医学里风险更高。GT 让 x₀ | c 偏离 p₀;论文在 w=1 时确实观察到变差(如 SiT-XL/2 FID 12.58 → 16.11)。医学场景如果因为合规/稳定性而必须用弱引导,这个代价会直接暴露。
- 全局 OT 是"欧氏距离最小化",它假设噪声空间与数据空间有可比的度量。对于"背景绝大部分是空气、前景是细小病灶"的 MRI,‖x₀−x₁‖² 这种耦合很可能把容量都花在背景上,而不是解剖结构。
- 配对语义未被验证:GT 会把不同条件关联到噪声的不同区域。在类条件 ImageNet 里这没关系(有 CFG 兜底),但在"必须精确对应某个受试者/某个模态"的医学任务里,这种错配是否可接受,论文没给任何证据。
这篇论文不是你的答案,但它提供的是一个低成本、可插拔的训练期旋钮。合理的做法是:把它当作一个"值得花一天做消融"的训练选项——用你自己的 3D MRI 流水线,固定网络与采样器,只把耦合从 independent 换成 GT,然后在若干引导强度下扫一遍(w = 1, 1.5, 2, 3, 4)。因为它的核心结论是"耦合选择要在实际推理用的引导流下评估",所以你必须在自己真实使用的 w 下比较,而不是只在 w=1 看。
换句话说:如果只看论文的"域"——它和 MRI 无关;如果看论文的"机制"——它是一个对任何 CFG-based 生成器都成立的通用的训练期改进,值得在 MRI 上试,但对 3D 体数据的有效性尚无任何证据。
你给的链接是 arxiv.org/pdf/2610.07555。这个编号(2610 = 2026 年 10 月)与 arXiv 上该论文的条目一致,但这些都发生在"未来"日期上,且我这次是从 arXiv 页面读到全文的。请自行确认这是你要找的那篇——如果你本来想找的是一篇**标题含 MRI / 脑影像 / 3D 医学**的论文,那两者的区别是根本性的,不要把这个页面的内容当成那篇来用。
01 — 30 秒速览
这篇论文到底做了什么
流匹配(flow matching)训练时,要把"噪声样本"和"数据样本"配成对,然后让模型学会从前者走到后者的速度场。 配对方式(coupling)自由度很大:随机配(independent)还是按最优传输配(OT)。 之前的共识是 OT 更好,因为它让轨迹更直、方差更小。本文问的是:条件生成 + CFG 的情况下,该怎么配?
① 提出了 GT
Global Transport:完全无视标签,对整批噪声与整批数据解一次全局 OT 配对。相比"每个类各解一次 OT"(C2OT),它在类别多或条件是连续向量(如文本嵌入)时都可行。
② 发现了一个反转
GT 在无引导条件下更差(因为它改变了每个条件所见的源分布 x₀|c),但在有 CFG 条件下全面更好。论文称这是 "reversal",并指出:不能用无引导性能来评判耦合选择。
③ 解释了机制
GT 缩小了 ‖g‖² = ‖ut(x|c) − ut(x)‖²("预测差"),从而缓解一种叫 yo-yo 效应的现象:独立耦合的引导轨迹会先收缩、再膨胀、甚至冲过目标区域。
④ 验证了广度
ImageNet-256 类条件(B/2、L/2、XL/2 三个规模,16/32/64 NFE)× 文本条件 × 单细胞;还验证了蒸馏成 flow map(few-step)时同样有效。
⑤ 最高引导区间是主战场
最关键的观察:用 GT 训练后,引导强度 w 可以推到大得多的值才开始退化,且 GT 与 independent 的差距随 w 增大而扩大。
⑥ 开销极小
训练时每步只多一次匈牙利算法配对。O(B²) 显存、O(B³) 时间,实测 SiT-B/2 上从 155.5 ms/step 增到 160.4 ms/step,+3.1%。
它把一个大家默认"工程细节"的东西——配对策略——提升成了一个有理论支撑的、独立的性能轴。而且它的核心洞见是方法论层面的:当你用引导/推理期技巧采样时,训练组件的优劣必须在"被引导后的流"上评估,而不是在原始的条件流上评估。这个教训可以推广到任何 inference-time 干预(guidance interval、投影、schedule …)与训练组件的交互。
02 — 动机与背景
为什么要重新想"怎么配对"
2.1 背景:流匹配与耦合
流匹配训练一个速度场 utθ,让样本从源分布 p₀(通常 𝒩(0, Id))连续演化到数据分布 p₁ = pdata。条件流匹配(CFM)的做法是先引入一个耦合 π ∈ Π(p₀, p₁)(即噪声与数据的联合分布),再对可解析的条件速度做回归:
配对的自由就在 π 上。独立耦合 π = p₀ ⊗ p₁ 是默认做法(随机配)。OT 耦合则求解最小化平方传输代价的联合分布:
OT 配对的轨迹在实践中更"直",因而在少步采样时更容易积分,在无条件生成里有稳定但不算大的提升。这是本文的出发点。
2.2 条件生成的两个麻烦
把 OT 搬到条件生成,会遇到两个障碍:
- 障碍一:类别多/条件连续时,"每类各解一次 OT"不可行。最小批次 OT-CFM 的自然扩展是对每个类 c 解 |𝒞| 个独立 OT 问题。ImageNet 有 1000 类就已经很吃力;而文本嵌入这类连续条件根本无法这样分组——你不可能为每一个可能的文本嵌入准备一个批次。
- 障碍二:CFG 的存在让"好坏"变得不直观。条件流模型几乎总是用 classifier-free guidance 采样,即在推理时把条件场与无条件场线性组合:
训练时,条件以一定概率被替换为 null token ∅,于是同一个模型同时学会条件场与边缘(无条件)场。关键点在于:CFG 采样走的是"两个场共同定义"的轨迹,而不是条件场单独的轨迹。而类别条件 OT(C2OT)分别改善的是条件场和无条件场,各自最优——把它俩线性组合起来是否还最优?没人验证过。
「一个同时考虑两个场的耦合,能否造出更好的被引导的生成器?」
这个提法的关键洞察是:耦合不是为"条件生成"服务的,而是为"CFG 采样"服务的。之前的 C2OT 一直在优化错的目标。
2.3 已有的 C2OT 做法与它的代价
已有工作(Kerrigan 等、Chemseddine 等、Cheng & Schwing)用一个可行的近似:把类别距离加进 OT 代价里,
这样可以用小得多的批次,但退化程度未知,因此在条件生成里始终没有被广泛采纳——独立耦合至今几乎是普遍做法。这为本文留下了空间。
03 — 方法
GT:一个无视标签的全局传输耦合
GT 的想法简单到近乎粗暴:既然按条件分组不可行,那就干脆不分组——把条件完全从配对里拿掉,对整批样本直接求一个全局 OT 指派。
3.1 目标函数
给定噪声样本 x₀ ~ p₀ 与带条件的数据样本 (x₁, c) ~ p₁,先用式 (2) 的 πOT 求耦合(忽略 c),再走标准线性流匹配路径 xt = t·x₁ + (1−t)·x₀。训练目标是:
其中 c̃ 以概率 puncond 取 ∅、否则取 c——也就是保留了标准的 CFG 训练流程。Algorithm 1 给出的训练步就是:采样批次 → 用匈牙利算法求全局指派 → 重排噪声 → 算 CFG 损失 → 反向传播。
3.2 两种实现
Minibatch-OT(论文默认,记作 GT)
在模型输入空间用平方欧氏代价跑匈牙利算法。批次大小 B 时,代价矩阵需 O(B²) 显存、精确指派需 O(B³) 时间。
论文指出这相对大模型的前向开销可以忽略,实测(Appendix C 表 8):独立耦合 155.5 ms/step、类条件 OT 157.9(+1.6%)、GT 160.4(+3.1%)。GT 略高于 C2OT,因为它不受"按类限制"的约束。
Semi-discrete OT(记作 GT + SD-OT)
先做一个昂贵的预处理:在所有离散数据点上优化一个半对偶势函数;之后就能对任意连续噪声测度快速算出耦合。
它的行为更接近"精确 OT 映射",因此在极高引导强度下最鲁棒,但在低 w 时达不到 GT 的全局最优 FID,且 FDDINOv2 明显更差(如 B/2 上 199.6 vs GT 的 123.6)。
3.3 代价:条件源分布失配
这是理解全文反转的关键机制,论文写得非常坦诚。考虑理想化的全批次设置,用真实 OT 耦合 πOT 及其传输映射 T: p₀ → p₁。抽 x₀ ~ p₀,令 x₁ = T(x₀),条件为 C。那么:
与"条件 c 的数据点"配对的那些噪声点,不需要服从 p₀——因为不同条件会被配到先验的不同区域。也就是说,虽然 x₀ ~ p₀,但条件分布 x₀ | C=c 通常不等于 p₀。
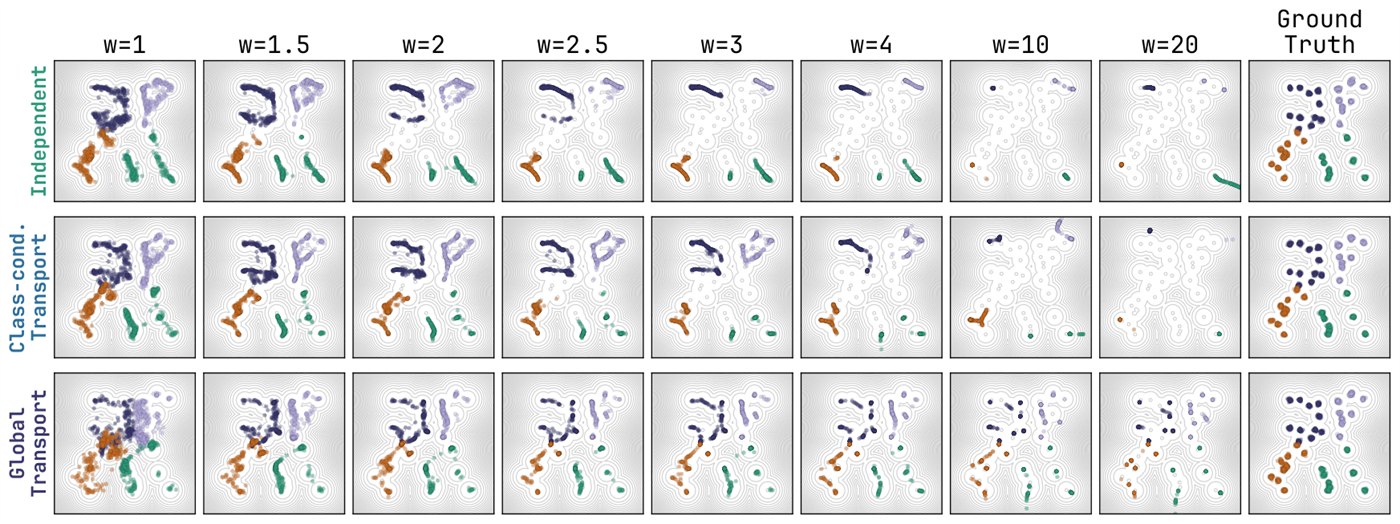
后果:在无引导设定(w = 1)下,用标准的"从 p₀ 采样再条件推理"流程,不一定会落在 p₁|c 上;要保证落在目标上,初始样本必须从那个难以计算的分布 x₀|C=c 里抽。论文在 40-高斯混合(4 类)的二维例子中证实了这一点。
但换到有引导(w > 1)时结论就翻转了。这个"依赖引导强度"的效应正是论文主张"要把两个场合起来研究"的实证基础。
04 — 交互
亲眼看一下 yo-yo 效应
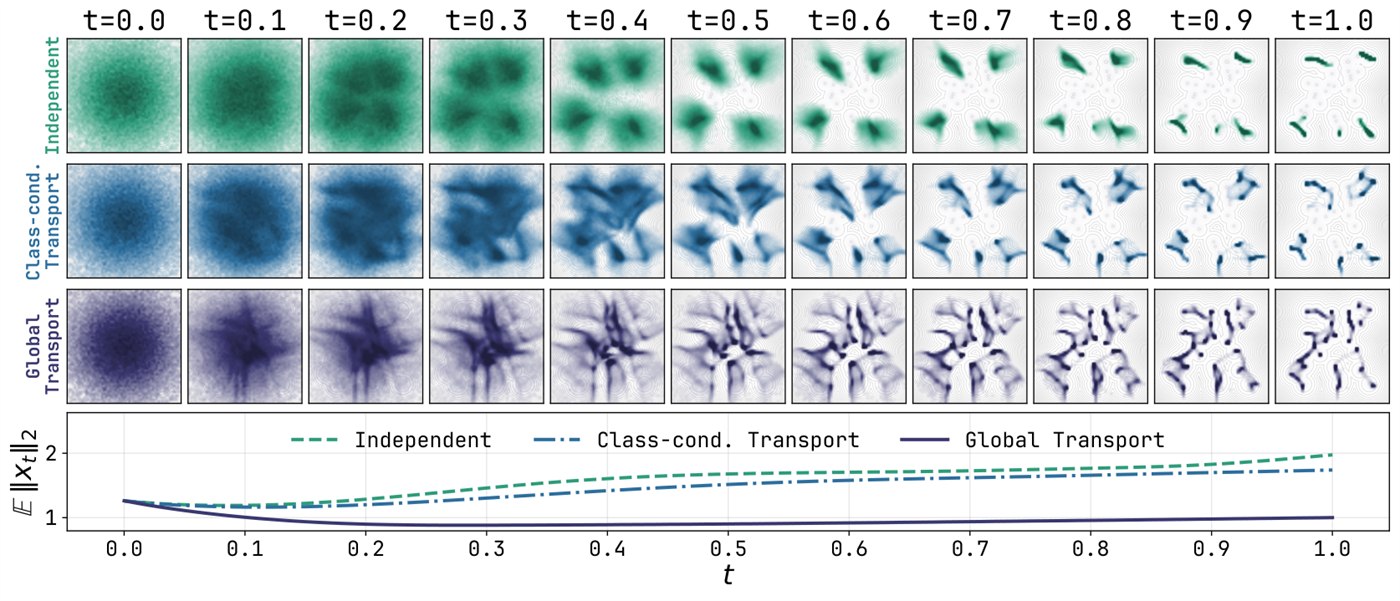
下面这个二维示意复现论文的 40-GMM 现象(Fig. 1–3)。横轴是流时间 t ∈ [0,1],纵轴是引导轨迹的径向范数 Yw(t) = 𝔼‖Xt(w)‖₂。 拖动引导强度 w,看三条曲线的差别:独立耦合(绿)会先收缩再明显外扩甚至冲过头——这就是 yo-yo;GT(紫)几乎不动。
读数对应论文 Fig. 1 / Fig. 3 的定性行为:w 越大,独立耦合的再膨胀与过冲越严重,最终把样本推出目标模态之外(生成质量下降);GT 的收缩与过冲都明显更小,这是它能承受高引导强度的原因。
这是一个定性示意,由论文描述的现象参数化重建(收缩再膨胀 + 过冲随 w 增强),不是论文数据的复现,也不是对 40-GMM 的重新仿真。论文的原始轨迹图见下方 Fig. 2 / Fig. 7 / Fig. 8。真实的定量结论请以上面的表格数据为准。
05 — 理论
为什么 GT 能缩小"预测差"
论文的理论目标很克制:它不声称证明了"GT 生成得更好",而是证明"GT 让预测差的上界更紧"。作者在正文里明确写了这个界限:"这些结果建立了更紧的上界,但并没有建立低预测差与性能提升之间的因果关系。我们用这个界来启发图 3 的测量,而不是作为生成性能的单独解释。"这种自我限制值得赞赏。
Proposition 4.1(传输代价界定路径上的预测差)
设 ut(x) 与 ut(x|c) 是同一个流匹配目标 x₁ − x₀ 在耦合 π 下的总体平方误差最小化器。那么:
其中 Cost(π) = 𝔼π‖x₁ − x₀‖²,𝒲₂² 是 2-Wasserstein 距离的平方。直观含义:耦合的传输代价越低,它能给出的"平均预测差上界"就越紧。
两个重要的限定(论文自己标注的):① 这个界严格地只沿训练用的线性插值路径成立,并不支配引导推理(w > 1)时访问到的状态分布——这一点论文用实验验证;② 在精确 OT 极限下界收缩到 0,因为确定性传输会让类条件在训练支撑上变得冗余;实践中有限批次的 OT 会保留非零的预测差,同时对速度场起到正则作用。
Proposition 4.2(耦合代价的层级)
对任意 β,耦合代价满足:
当 β = 0 时左侧取等号。结合 Prop 4.1,这就建立了预测差上界的层级:GT 比 C2OT(β>0)更紧,C2OT 比独立耦合更紧。
论文的证明思路(Appendix B.2):πGT⋆ 是无约束的 OT 解,所以它必然不劣于任何满足同样边缘约束的耦合,包括 C2OT 的解;而 πC²OT(∞)⋆ 恰好退化为"各类分别做 OT"的加权和,可以逐类用 OT 的最优性证明它 ≤ 独立耦合的代价。
Appendix B.3:耦合控制流的曲率
为了给"轨迹更直"一个解析支撑,论文构造了一个高斯 plug-in 的小批次 OT 模型(取 p₀ = p₁ = 𝒩(0, Id),对小批次拟合均值协方差后用高斯 Monge 映射配对,再对批次求边缘化),并计算"物质加速度" at[v](x) = ∂tvt(x) + Dxvt(x)·vt(x)。结论(Prop B.4):
即:独立耦合的总物质加速度是 O(1),小批次 OT 是 O(n⁻¹),总体 OT 为 0。这解释了为什么 OT 配对能让轨迹更直、更容易数值积分。
- 预测差的界不支配 CFG 轨迹上真正访问到的状态,也不保证由此产生生成质量的层级。
- 高斯 plug-in 模型是为了解析可处理性而选的代理,不等同于实验中真正使用的离散匈牙利耦合——作者明说后者的精确分析"会复杂得多"。
- 因此这篇论文的贡献定位在"机制性的上界 + 一致的实证",而不是"因果性的性能证明"。
06 — 实验
实验数据
三块实验:ImageNet-256 类条件、ImageNet-256 文本条件、单细胞基因表达。主力指标是 FID 和 FDDINOv2(后者基于 DINOv2 特征,对分布差异更敏感),以及自适应求解器下的 NFE(函数评估次数)。
类条件图像生成 · ImageNet-256
批次 256 · 每尺度扫最优 w*
主结果(论文 Table 2):在所有 NFE(16/32/64)与所有模型规模下,GT 耦合都取得最强性能。三个颜色标记对应三种耦合。
| 模型 | 耦合 | 16 步 FID | 32 步 FID | 64 步 FID | 16 步 FDDINOv2 | 32 步 FDDINOv2 | 64 步 FDDINOv2 |
|---|---|---|---|---|---|---|---|
| — | Independent | 5.88 | 5.33 | 5.16 | 137.3 | 132.9 | 132.3 |
| — | Class-cond. OT | 5.79 | 5.20 | 5.08 | 136.4 | 132.2 | 131.4 |
| — | GT + SD-OT | 5.11 | 4.90 | 4.85 | 199.6 | 194.6 | 184.7 |
| SiT-B/2 130M | GT | 5.15 | 4.35 | 4.15 | 123.6 | 118.0 | 116.4 |
| — | Independent | 5.50 | 5.74 | 2.95 | 91.1 | 84.6 | 83.3 |
| — | Class-cond. OT | 5.47 | 5.68 | 2.98 | 102.0 | 99.2 | 95.0 |
| SiT-L/2 459M | GT | 3.94 | 3.84 | 2.69 | 83.5 | 78.7 | 73.5 |
| — | Independent | 3.95 | 3.00 | 2.78 | 84.2 | 78.7 | 77.8 |
| SiT-XL/2 675M | GT | 3.22 | 2.69 | 2.59 | 72.7 | 69.1 | 68.4 |
注意 GT + SD-OT 的 FDDINOv2 明显更差(184–200 vs GT 的 116–124)——论文指出它更接近精确 OT,在高引导下最鲁棒,但达不到 GT 的全局最优 FID。另外 SiT-XL/2 那一行论文只报了 Independent 和 GT 两者。
最关键的发现:差距随 w 增大而扩大
论文 Table 1 的最佳配置是 SiT-XL/2 + GT,把 FID 从 2.06 降到 1.91(用了 guidance interval)。但论文说"这一个结果背后有更有意思的故事":用 GT 训练后,引导强度 w 可以推到比独立耦合高得多的值才开始退化,而且 GT 与独立耦合的差距随 w 单调扩大,同时在 FID 最小值上也整体更优。
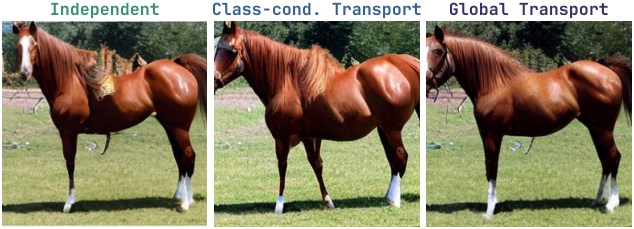
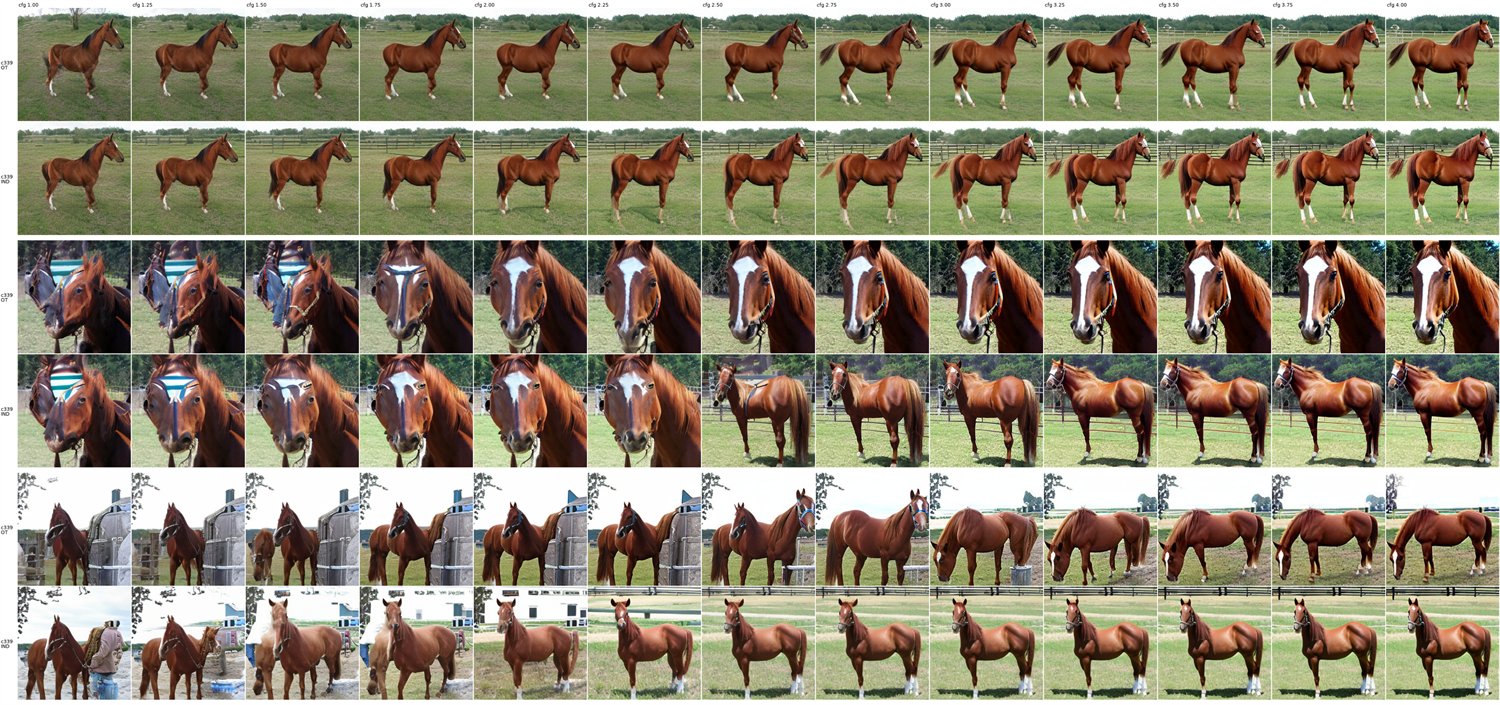
下面的完整扫描表把这个趋势量化得很清楚(论文 Table 9):GT 的最优点是 w ≈ 2(FID 4.15 / 2.69 / 2.59),但它到 w = 10 时 FID 仍是 21.62 / —— / ——,而独立耦合此时已经崩到 23.28。
完整引导强度扫描(论文 Table 9,FID ↓)
| 模型 | 耦合 | w=1.0 | 1.5 | 2.0 | 2.5 | 3.0 | 3.5 | 4.0 | 5.0 | 6.0 | 8.0 | 10.0 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SiT-B/2 | Ind. | 26.44 | 6.68 | 5.16 | 7.93 | 11.04 | 13.65 | 15.76 | 18.63 | 20.42 | 22.40 | 23.28 |
| C²OT | 26.72 | 6.70 | 5.08 | 7.81 | 10.90 | 13.47 | 15.59 | 18.44 | 20.28 | 22.25 | 23.12 | |
| GT | 31.16 | 8.13 | 4.15 | 5.88 | 8.72 | 11.32 | 13.41 | 16.51 | 18.62 | 20.81 | 21.62 | |
| SiT-L/2 | Ind. | 13.85 | 2.95 | 3.86 | 5.85 | 10.10 | 13.53 | 16.03 | 17.89 | — | — | — |
| C²OT | 13.96 | 2.98 | 3.84 | 5.81 | 10.02 | 13.42 | 15.93 | 17.79 | — | — | — | |
| GT | 17.72 | 2.96 | 2.69 | 3.88 | 7.38 | 10.66 | 13.25 | 15.17 | — | — | — |
读法:注意 w = 1(无引导)那一列——GT 反而最差(31.16 vs 26.44)。这正是论文说的 "reversal":无引导性能与引导性能不相关。而从 w ≥ 2 开始 GT 反超,且领先幅度随 w 单调拉大。C²OT 与独立耦合几乎一模一样——这说明"按类分组的 OT"在这个设置里几乎没有价值。
蒸馏成 flow map(少步生成)
教师 = 预训练 SiT · 学生 = flow map
论文跟 Lee 等(2026)的设置,把 SiT-B/2 与 L/2 的 flow matching 教师用 meanflow 目标蒸馏成 flow map 学生。有一个很漂亮的发现:在 SiT-B/2 上,只在蒸馏阶段用 GT(教师是独立耦合预训练的)就能达到"全程用 GT 预训练"的效果——这说明 GT 可以纯粹作为一种蒸馏策略来使用。
| 模型 | 耦合 | 教师 16 步 | 教师 32 步 | 教师 64 步 | 学生 1 步 | 学生 2 步 | 学生 4 步 |
|---|---|---|---|---|---|---|---|
| DMF-B/2 | Independent | 5.88 | 5.33 | 5.16 | 5.82 | 5.19 | 5.19 |
| Class-cond. OT | 5.79 | 5.20 | 5.08 | 5.83 | 5.18 | 5.25 | |
| GT(GT 教师) | 5.15 | 4.35 | 4.15 | 5.66 | 4.17 | 4.14 | |
| GT(独立教师) | 5.88 | 5.32 | 5.22 | 5.88 | 4.21 | 4.18 |
最后一行的含义:教师只用独立耦合预训练(5.88 / 5.32 / 5.22),但学生只在蒸馏时用了 GT,2 步/4 步就达到 4.21 / 4.18,与"全程 GT"的 4.17 / 4.18 基本持平。这是一个非常实用的结论——你可以对已有的模型做一次 GT 蒸馏来获得少步加速。
文本条件(连续条件)· 自适应求解器
冻结 DFN5B CLIP ViT-H/14 文本塔 · 1024 维
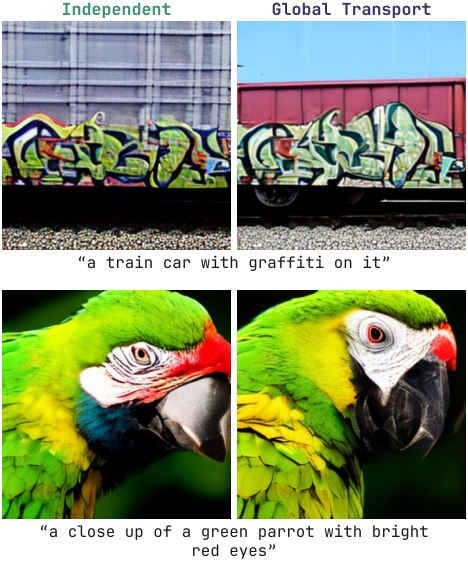
这一块的实验设计很聪明:它证明了 GT 在连续条件下也能用——而这正是 C²OT 根本无法实施的情形(你没法为每个 1024 维文本嵌入准备一个批次)。每张 ImageNet-1k 图像配 VisualLayer 的字幕,用冻结的 CLIP 文本塔编码成 ℓ₂-归一化的 1024 维向量,null 条件为零向量。
自适应步采样(dopri5)
| w | 独立 FID / FD / NFE | C²OT FID / FD / NFE | GT FID / FD / NFE | GT+SD-OT FID / FD / NFE |
|---|---|---|---|---|
| 1.0 | 25.01 / 586.5 / 50.8 | 25.23 / 589.0 / 47.7 | 29.65 / 618.8 / 49.2 | 42.39 / 772.6 / 38.0 |
| 2.0 | 5.17 / 206.4 / 61.0 | 5.08 / 209.0 / 60.6 | 4.06 / 220.1 / 61.5 | 7.56 / 341.0 / 50.0 |
| 3.0 | 11.13 / 138.3 / 76.4 | 10.98 / 138.0 / 75.8 | 8.77 / 130.6 / 73.5 | 4.79 / 227.0 / 62.8 |
| 4.0 | 15.77 / 132.9 / 90.0 | 15.56 / 132.1 / 89.9 | 13.37 / 116.3 / 85.6 | 5.47 / 194.0 / 77.1 |
论文的表述是:GT 整体取得最低的 FID 与 FDDINOv2,而半离散 GT 需要最少的函数评估次数并在高引导强度下优于其他耦合。注意 w = 4 时 GT+SD-OT 的 FID 最低(5.47)但 FD 很差(194.0)——两个指标的取舍不一致,这也是论文只声称"GT 整体最优"而非"每个格子都赢"的原因。
单细胞基因表达
按细胞类型条件 · 3 个种子平均
跟随 Palma 等(c-CFGen)的设置,按细胞类型条件生成。数据集:PBMC3K(2,638 个外周血单核细胞,8 种类型)、Dentate gyrus(18,213 个小鼠海马细胞,14 种类型)、HLCA(584,944 个人肺细胞,486 个个体,50 种类型)。指标是 RBF 核 MMD 与 2-Wasserstein 距离。
| 方法 | PBMC3K MMD | PBMC3K WD | Dentate gyrus MMD | Dentate gyrus WD | HLCA MMD | HLCA WD |
|---|---|---|---|---|---|---|
| c-CFGen | 0.45 ± 0.00 | 11.17 ± 0.02 | 0.06 ± 0.00 | 7.26 ± 0.03 | 0.06 ± 0.00 | 5.06 ± 0.00 |
| c-CFGen-linear | 0.41 ± 0.00 | 10.27 ± 0.08 | 0.06 ± 0.00 | 6.69 ± 0.01 | 0.07 ± 0.00 | 4.89 ± 0.01 |
| scDiffusion | 0.67 ± 0.06 | 12.11 ± 0.16 | 0.06 ± 0.00 | 5.89 ± 0.01 | 0.12 ± 0.00 | 5.42 ± 0.01 |
| scVI | 0.58 ± 0.01 | 13.39 ± 0.16 | 0.11 ± 0.00 | 7.34 ± 0.03 | 0.13 ± 0.00 | 6.39 ± 0.01 |
| GT(本文) | 0.39 ± 0.00 | 9.80 ± 0.02 | 0.05 ± 0.00 | 6.61 ± 0.01 | 0.07 ± 0.00 | 4.98 ± 0.00 |
论文的如实表述:"GT 在六项指标中三项最好、三项第二。"败给 scDiffusion 的是 Dentate gyrus 的 WD(6.61 vs 5.89),败给 c-CFGen-linear 的是 HLCA 的 WD(4.98 vs 4.89)与 MMD(0.07 vs 0.07,并列)。这比摘要里常见的"全面领先"要克制得多。
补充:40-GMM 合成实验(定性机制验证)
论文在 Appendix A 用了一个二维 40 高斯混合、4 类的玩具问题来可视化和验证机制:μi ~ 𝒰(−40,40)²,共享各向同性协方差 Σ = diag(40,40)。主要观察:
- 密度的时序演化(Fig. 2):独立耦合的样本先向"类原点"收缩、再向外膨胀(yo-yo);GT 稳定得多。
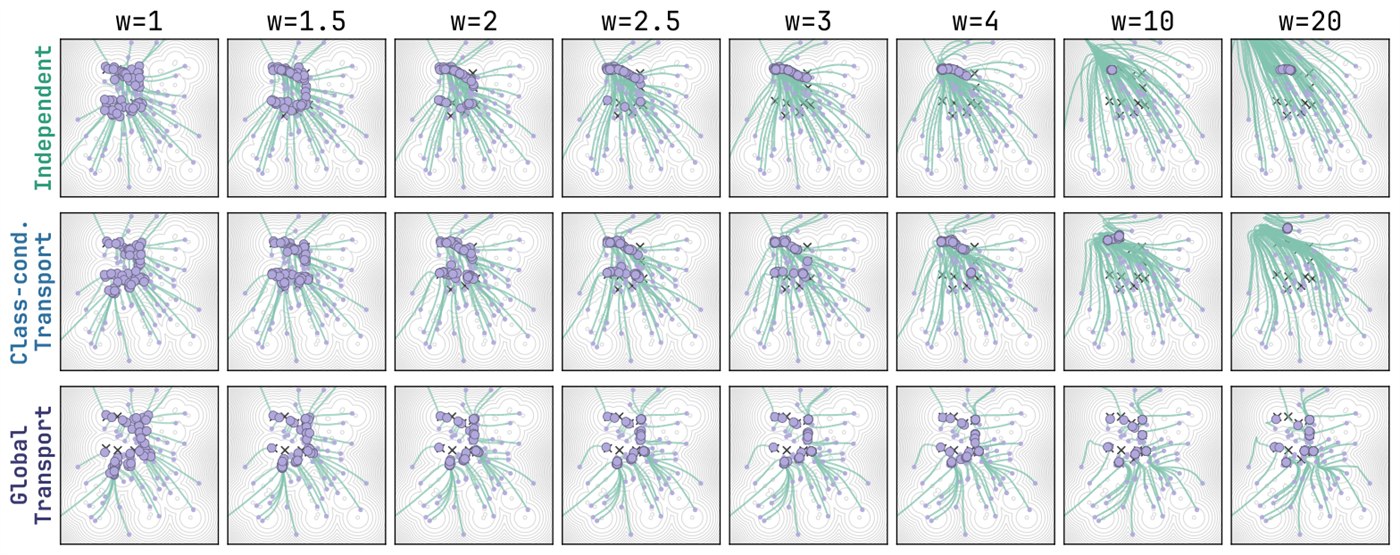
- 轨迹(Fig. 7):独立耦合的轨迹在接近条件类时会先向内弯再向外弯。
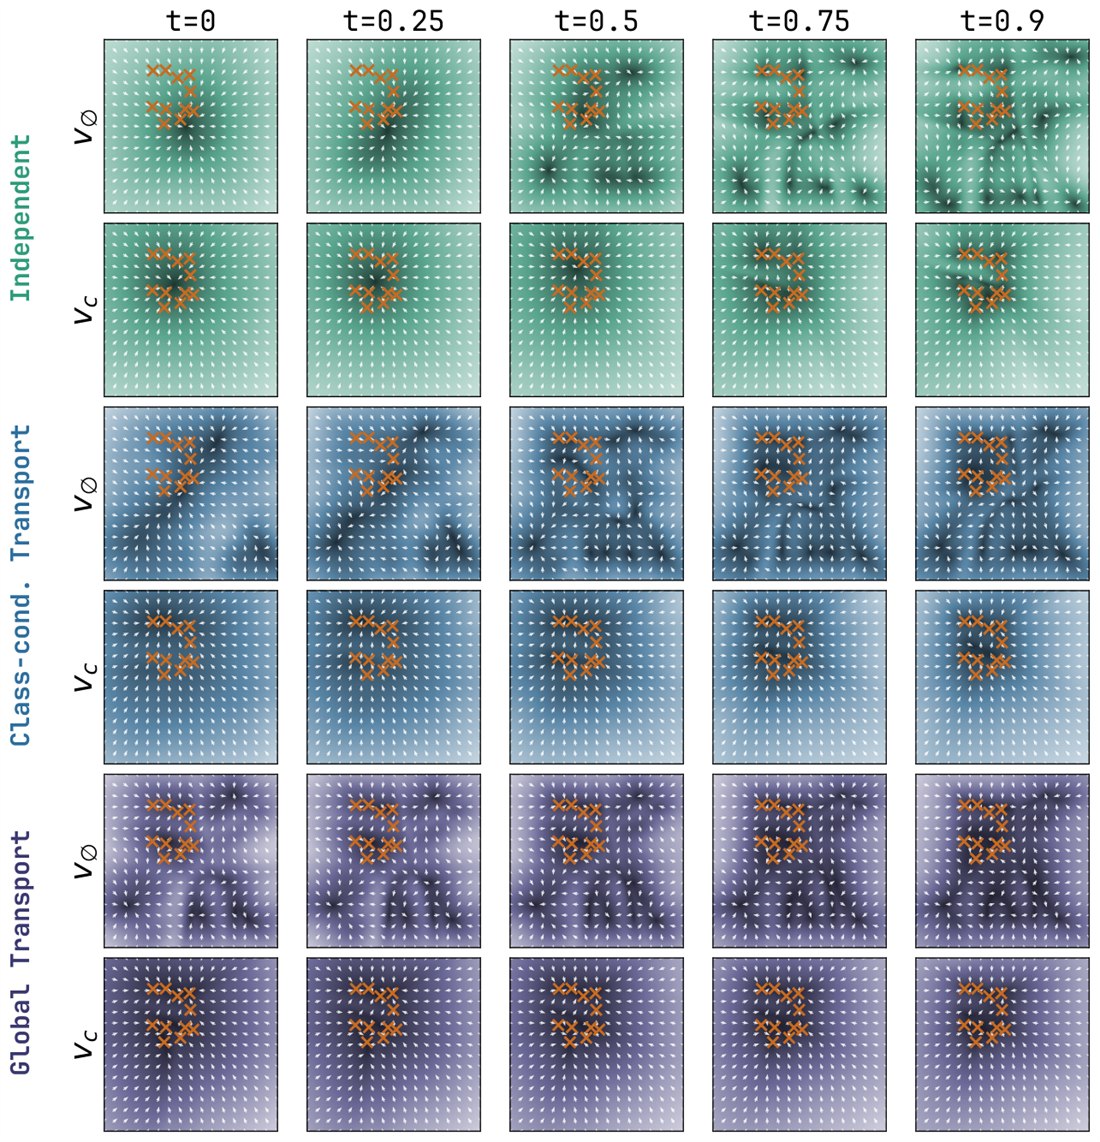
- 速度场热图(Fig. 8):独立耦合下条件场与无条件场都从一个位于类原点附近的"汇"开始,在 t = 0.5 附近剧烈重组;而 GT 下无条件速度场在 t = 0 就已经成形,并在整条轨迹上保持稳定。
- 极高引导(Fig. 9):论文额外提供了 w = 20 的样本,展示 GT 即便在极端引导下也不掉模态。
训练配置与超参数(论文 Table 6 / 7)
| 项目 | B/2 | L/2 | XL/2 |
|---|---|---|---|
| 参数量 (M) | 130 | 458 | 675 |
| FLOPs (G) | 23.1 | 80.7 | 118.6 |
| 隐藏维度 | 768 | 1024 | 1152 |
| 注意力头数 | 12 | 16 | 16 |
| 层数 | 12 | 24 | 28 |
| 训练迭代(SiT) | 800K | 800K | 800K |
| 类别 dropout 概率 | 0.1 | 0.1 | 0.1 |
优化器 AdamW,批次 256,学习率 1e-4,(β₁,β₂) = (0.9, 0.95),ε = 1e-8,权重衰减 0,EMA 衰减率 0.9999。所有 ImageNet-256 实验统一批次 256。DMF 蒸馏 400K 迭代、80 epochs,通过 meanflow 自蒸馏目标微调预训练 SiT,对角分割 0.5。
07 — 迁移性分析
如果真想用到 3D 脑 MRI 上,具体会发生什么
这一节不是论文的内容,而是基于论文机制推演出的迁移路径与风险。我会把"论文支持的"和"我的推断"严格分开标注。
7.1 为什么机制上"看起来"适配
- MRI 生成几乎都带条件(模态如 T1/T2/FLAIR、分割标签、年龄/性别/诊断、甚至文本报告)。只要用了 CFG,论文的结论在形式上就适用。
- 条件空间既大又连续——多中心、多扫描仪、连续变量与文本混在一起。C²OT 在这里根本跑不起来(要按条件分组),而 GT 恰恰绕开了这个要求,这是它相对 C²OT 的真正优势。
- 训练成本几乎不变。论文实测 +3.1%/step。3D MRI 的瓶颈在体数据的 UNet/DiT 前向与显存,配对开销可忽略。甚至批次越小,O(B³) 越便宜。
- 少步生成也有戏。论文显示 GT 可以只在蒸馏阶段使用就获得收益(DMF-B/2 的 2 步 4.21 vs 独立 5.19)。对 3D 医学影像(采样步数直接决定推理成本)这是最实用的一条。
7.2 为什么收益可能缩水甚至变负
A · 引导强度是收益的来源
论文的收益结构非常清楚:GT 在 w = 1 时更差,从 w ≈ 2 起反超,差距随 w 单调扩大。
而医学影像生成实践中,出于"不要虚构病灶 / 保持解剖保真"的考虑,往往采用较保守的引导强度,甚至刻意降低 CFG 以避免过度锐化与伪影。若你实际用的 w 落在 1–1.5,你可能正好落在 GT 的劣势区间。
→ 这决定了你的消融必须在你真实使用的 w 上做,不能照抄论文的"GT 更好"。
B · 欧氏 OT 在体数据上的偏置
GT 用 ‖x₀ − x₁‖² 做代价——纯欧氏距离,对"哪些像素重要"一无所知。医学体数据典型特征是背景占绝大多数体素、解剖结构与病灶占比极小。
这带来一个我在论文里找不到答案的问题:全局欧氏 OT 会不会把大部分传输预算花在背景的匹配上,从而让前景结构(真正关心的部分)得到更少的配对"注意力"?在 2D 自然图像 + 类条件下这似乎不是问题,但体数据的稀疏前景让这个风险显著上升。
→ 这是论文完全没有覆盖的失效模式,属于我的推断,需要你自己的实验验证。
GT 的核心代价是"条件 c 的源分布 x₀|c 不再等于 p₀"。在 ImageNet 里这可以接受,因为条件只是"1000 类之一",错配的后果被 CFG 的大 w 强行拉回。
但在医学影像里,条件经常承载临床上必须精确成立的信息:这是哪个模态、有没有某个病灶、属于哪个人群。如果 x₀|c 的失配在这些维度上是系统的(比如某个模态总是配到噪声空间的某个区域),那么"高 w 强行拉回"可能掩盖问题,也可能在少数条件上制造系统性偏差。论文没有任何实验能回答"条件错配在临床上可不可接受"——这需要按条件分层的评估,而不是单一 FID。
7.3 如果要做,我建议的实验方案
- 控制变量:固定网络(如 3D DiT / UNet)、固定采样器与步数、固定数据划分。只把耦合从 independent 换成 GT(外加 C²OT 作为参考,虽然它在连续条件下难做)。
- 关键设计:在 w ∈ {1, 1.5, 2, 3, 4, 6} 上完整扫一遍,画出 FID/FDDINOv2 曲线。目标不是"看 GT 是否更好",而是"看 GT 的最优 w 是否更高,以及在你实际使用的 w 上是否更好"。
- 必须加的条件分层指标:按模态、按中心、按病灶有无分别评估。单一全局 FID 会掩盖 7.2 里那个系统性偏差。
- 顺带验证论文最漂亮的结论:用独立耦合预训练一个模型,然后只在蒸馏阶段换 GT,看少步(2/4 步)质量是否提升。这对 3D 推理成本的收益可能比对 FID 更大。
- 值得额外试的自变量:由于 7.2-B 的背景主导问题,可以试加权的欧氏代价(前景/解剖区域加权)来做 OT 配对。论文用的是纯欧氏代价,但它的框架允许换代价函数——这可能是一个比直接套用更有价值的改进点。
论文本身与 MRI 无关,作者甚至明确把这个方向列为"未解决"。但它的机制是一个可插拔的训练期旋钮,形式上适用于任何 CFG-based 的 3D MRI 生成器。收益能否兑现取决于两件论文没测的事:你实际使用的引导强度,以及欧氏 OT 代价在稀疏前景体数据上的行为。花一两天做上面那个消融是值得的;把它当成"3D MRI 生成的新突破"来期待则没有依据。
08 — 批判性评估
哪些地方站得住,哪些要存疑
站得很稳
- 方法极简且真的便宜:+3.1%/step、零推理改动、零架构改动。这类方法的复现门槛低,可信度高。
- 跨规模/跨 NFE 的一致性:3 个模型规模 × 3 个 NFE,GT 全部最优(表 1)。不是单点调优的结果。
- 数据掏得很充分:论文把每个耦合在各 w、各模型、各 NFE 下的完整数字都放出来了(Table 9/10),而不是只报自己的最好成绩。
- 理论定位诚实:明确写了"上界更紧 ≠ 生成更好",没有把 Prop 4.1/4.2 包装成因果证明。
- 单细胞结果如实报告:"三项最好、三项第二",没有回避输给 scDiffusion 的那一项。
要打折看
- C²OT 基线几乎等于独立耦合(表 1 的 B/2:5.88 vs 5.79)。这意味着论文主要对比的是一个"几乎没用的基线",真正的对手(更强的引导期方法)没有被比较。
- 两指标经常互相矛盾:GT+SD-OT 在 w=4 的 FID 最低(5.47)但 FDDINOv2 最差(194.0);论文自己的表 1 里 SD-OT 的 FD 也明显更差。选择性地用两个指标讲"GT 最优"有解释空间。
- "GT 最优"依赖于引导区间调优。Table 1 那个 2.06 → 1.91 用了 guidance interval。没有 interval tuning 时的对比(Table 10 的 Full 列)GT 优势更小。
- w=1 时 GT 明显更差(XL/2:12.58 → 16.11)。这是真实代价,论文承认,但如果你的流程有一步需要无引导采样(如部分编辑/反演任务),GT 会直接伤害它。
证据空缺
- 没有任何定理连接"更小的预测差"与"更好的生成"。作者自己说了这一点。所以核心叙事 GT → 更小 gap → 更好质量 的中间那一步始终是经验性的、单点的(只有 Fig. 3 的测量)。
- 没有图像/视频之外的域。除了单细胞(1D 向量,且只有 3 项最优),完全没有 3D、音频、科学场等其它模态。所谓"跨域"其实只在图像上跨了条件类型。
- 缺关键消融:没有报告"GT 配对 + 但使用非 CFG 的其它引导(如 autoguidance、projection-based)"会怎样。论文在相关工作中提了这些方法,却没做交互实验。而它的核心论点是"要在实际推理流下评估耦合",那么与其它推理期方法的交互恰恰是最该测的。
- 批次大小的敏感性未探讨。GT 的小批次近似质量随 B 变化(这与 \beta 之于 C²OT 同理),论文固定 256 批次。小批次(医学影像常见的显存限制)下 GT 是否还成立,没有数据。
- 单细胞的种子极少:Appendix D 写"我们的评估脚本使用 0,1,2 种子"。3 个种子支撑"三项最好"的结论偏弱。
值得追问的技术问题
- 预测差是不是正确的中间变量?论文的因果链是 耦合 → (上界紧的) 预测差 → 引导轨迹稳定 → 质量。但 Prop 4.1 的界只在训练插值路径上成立,而收益发生在推理轨迹上。论文说"我们经验性地验证了这一点"(Fig. 3),但这仍是相关性。是否存在第三个混杂因素(比如 GT 恰好让无条件场更早成形——Fig. 8 的观察)在起作用?Fig. 8 里 GT 的无条件场在 t=0 就成形这个现象,可能比预测差更本质。
- 为什么 C²OT 这么弱?理论上 C²OT 的耦合代价介于 GT 与独立之间(Prop 4.2),预测差上界也应该介于两者之间。但实验里 C²OT 的表现几乎等于独立耦合(表 1、表 3)。这个理论与实验的落差,论文没有解释。一个可能的原因是 β 的缩放(βm=10)导致实际上几乎退化为"每类各自 OT",而每个类内部的 OT 与全局独立耦合的差别在 ImageNet 尺度上很小。
- SD-OT 的两个指标矛盾说明什么?GT+SD-OT 的 FDDINOv2 系统性更差(表 1 里 118–200 vs GT 116–124),但 FID 在高引导下更好。FDDINOv2 用的是 DINOv2 语义特征,更接近"感知/语义质量";FID 更接近"分布统计"。两者背离意味着 SD-OT 可能是在像素统计上更匹配,但语义/结构上更差。论文没有讨论这个背离的含义。
- GT 与"reflow"类方法的关系?相关工作提到 re-flow 式策略利用流的可逆性。GT 本质上也是一种"重配对",两者在概念上相邻。没有对比,读者无法判断 GT 相对于已有的重配对方案(如 Berthelot 等的 distilled normalizing flows)到底新在哪、好在哪。
- 批次内的条件分布是否重要?GT 忽略标签,但一个批次的条件构成会影响全局 OT 的结果。如果某个批次恰好集中在少数几类上,配对会偏。论文没有讨论批次采样策略(分层?随机?)与 GT 的交互——而这是一个非常实际、可能影响结果的工程细节。
- 能否扩展到"部分条件无关"的情形?有些条件应该被忽略(如扫描仪型号),有些必须精确。GT 对所有条件一视同仁。能否对条件做分组、组内 GT 组间 C²OT?这是论文框架允许但未探索的中间地带。
这是一篇漂亮的"小"论文:想法一句话能说清,实现便宜到几乎免费,结论跨规模跨步数一致,数据掏得干净,理论上也不越界。它最扎实的贡献其实不是 GT 本身,而是那个方法论提醒——当推理期用了引导,训练组件的优劣必须在被引导的流上评估,无引导性能会误导你。
它最薄弱的地方是因果链的中间环节:整个解释建立在"预测差更小 → 生成更好"上,而作者自己拒绝声称这一步,实验也只有一处(Fig. 3)测量。以及它的"域外推广"其实相当有限——单细胞之外没有跨出图像领域,作者也把生命科学中的迁移明确列为开放问题。
09 — 速查
一页带走
核心公式
| 式子 | 内容 | 作用 |
|---|---|---|
| N/A | ℒCFM = 𝔼‖utθ(xt) − ut(xt|x₀,x₁)‖² | 条件流匹配:对给定耦合做回归 |
| (3) | ũw = ut(xt) + w·g,g = ut(x|c) − ut(x) | CFG:推理时线性组合两个场 |
| (2) | πOT = argmin 𝔼‖x₀ − x₁‖² | 最优传输耦合的定义 |
| (4) | πC²OT = argmin 𝔼[‖x₀−x₁‖² + β‖c₀−c₁‖²] | 类条件 OT:把类别距离加进代价(需按组分批) |
| (5) | ℒGT = 𝔼πOT‖utθ(xt, c̃) − (x₁−x₀)‖² | GT 的核心:用无视标签的 OT 耦合,但保留 CFG 的 dropout |
| (6) | 𝔼t,π‖g‖² ≤ Cost(π) − 𝒲₂²(p₀,p₁) | Prop 4.1:传输代价界定预测差 |
| (7) | Cost(πGT) ≤ Cost(πC²OT) ≤ Cost(πind) | Prop 4.2:耦合代价的层级 |
| N/A | Yw(t) = 𝔼‖Xt(w)‖₂ | 度量 yo-yo 效应的量:引导轨迹的径向位置 |
术语对照
| 术语 | 含义 |
|---|---|
| GT(Global Transport) | 本文提出的方法:无视条件标签的全局最优传输耦合。对整批噪声和数据解一次 OT 指派。 |
| Coupling(耦合) | 噪声样本与数据样本的联合分布 π ∈ Π(p₀,p₁)。它决定训练时"谁配谁",从而决定学习到的轨迹形状。 |
| CFG(Classifier-Free Guidance) | 推理时把条件场与无条件场线性组合,用 w 控制引导强度。几乎是有条件生成的标准做法。 |
| Prediction gap(预测差) | ‖g(x,t,c)‖²,即条件与无条件速度场之间的差距。CFG 本质上是在放大这个 gap。 |
| Yo-yo effect(溜溜球效应) | 本文命名的现象:独立耦合的引导轨迹会先收缩再膨胀,w 越大过冲越严重,把样本推出目标模态。GT 显著缓解它。 |
| Conditional source mismatch | GT 的代价:条件的源分布 x₀|c 不再等于先验 p₀,导致无引导(w=1)条件生成变差。 |
| C²OT(Class-conditional OT) | 已有方法:把类别距离加进 OT 代价。需要按条件分批,连续条件(如文本)下不可行。 |
| SD-OT(Semi-discrete OT) | GT 的另一种实现:先用昂贵的预处理求半对偶势,之后可对任意连续噪声快速配对。更接近精确 OT。 |
| Flow map / DMF | 把流匹配模型蒸馏成"一步或少步"跳转的映射。本文验证了 GT 作为蒸馏策略的有效性。 |
| Guidance interval | 只在时间区间 [a,b] 内施加引导(如 [0,0.7])的调优技巧。论文确认它对所有耦合都有帮助。 |
如果你要自己试
- 最小改动:在训练循环里,拿到一个批次后先用匈牙利算法(在模型输入空间、平方欧氏代价)求全局指派,按指派重排噪声,其余训练流程完全不变。
- 评估方式必须改:不要用 w=1 判断好坏。在多个 w 上扫,报告曲线而不只是一个数。
- 先查两件事是否与论文一致:① 你的流程里 GT 的最优 w 是否比独立耦合更高;② 高 w 时 GT 是否更稳。这两点若成立,说明机制在你的域里也生效。
- 最省事的用法:如果你已有预训练模型,只在蒸馏/微调阶段换成 GT(论文显示这几乎等价于全程 GT)。
- 批次不要太小:论文用 256。批次越小,全局 OT 的近似质量越差,收益可能消失(论文未测,属推断)。