JEPA-Anything · 论文精读用正交预测分解学一个跨世界的预测模型
JEPA-Anything: Learning Predictive Models across Different Worlds
Taoyong Cui, Zhongyao Wang, Xinyue Xu, Weiyang Liu, Zhaochen Yu, Yuying Zhang, Qiang Gao, Mengyue Yang, Wanli Ouyang, Pheng Ann Heng*, Yingcheng Wu*, Zhenfei Yin*, Ling Yang*
PhAI Labs · 香港中文大学 · 复旦大学 · 香港城市大学 · 布里斯托大学 · 斯坦福 · 牛津 · 普林斯顿
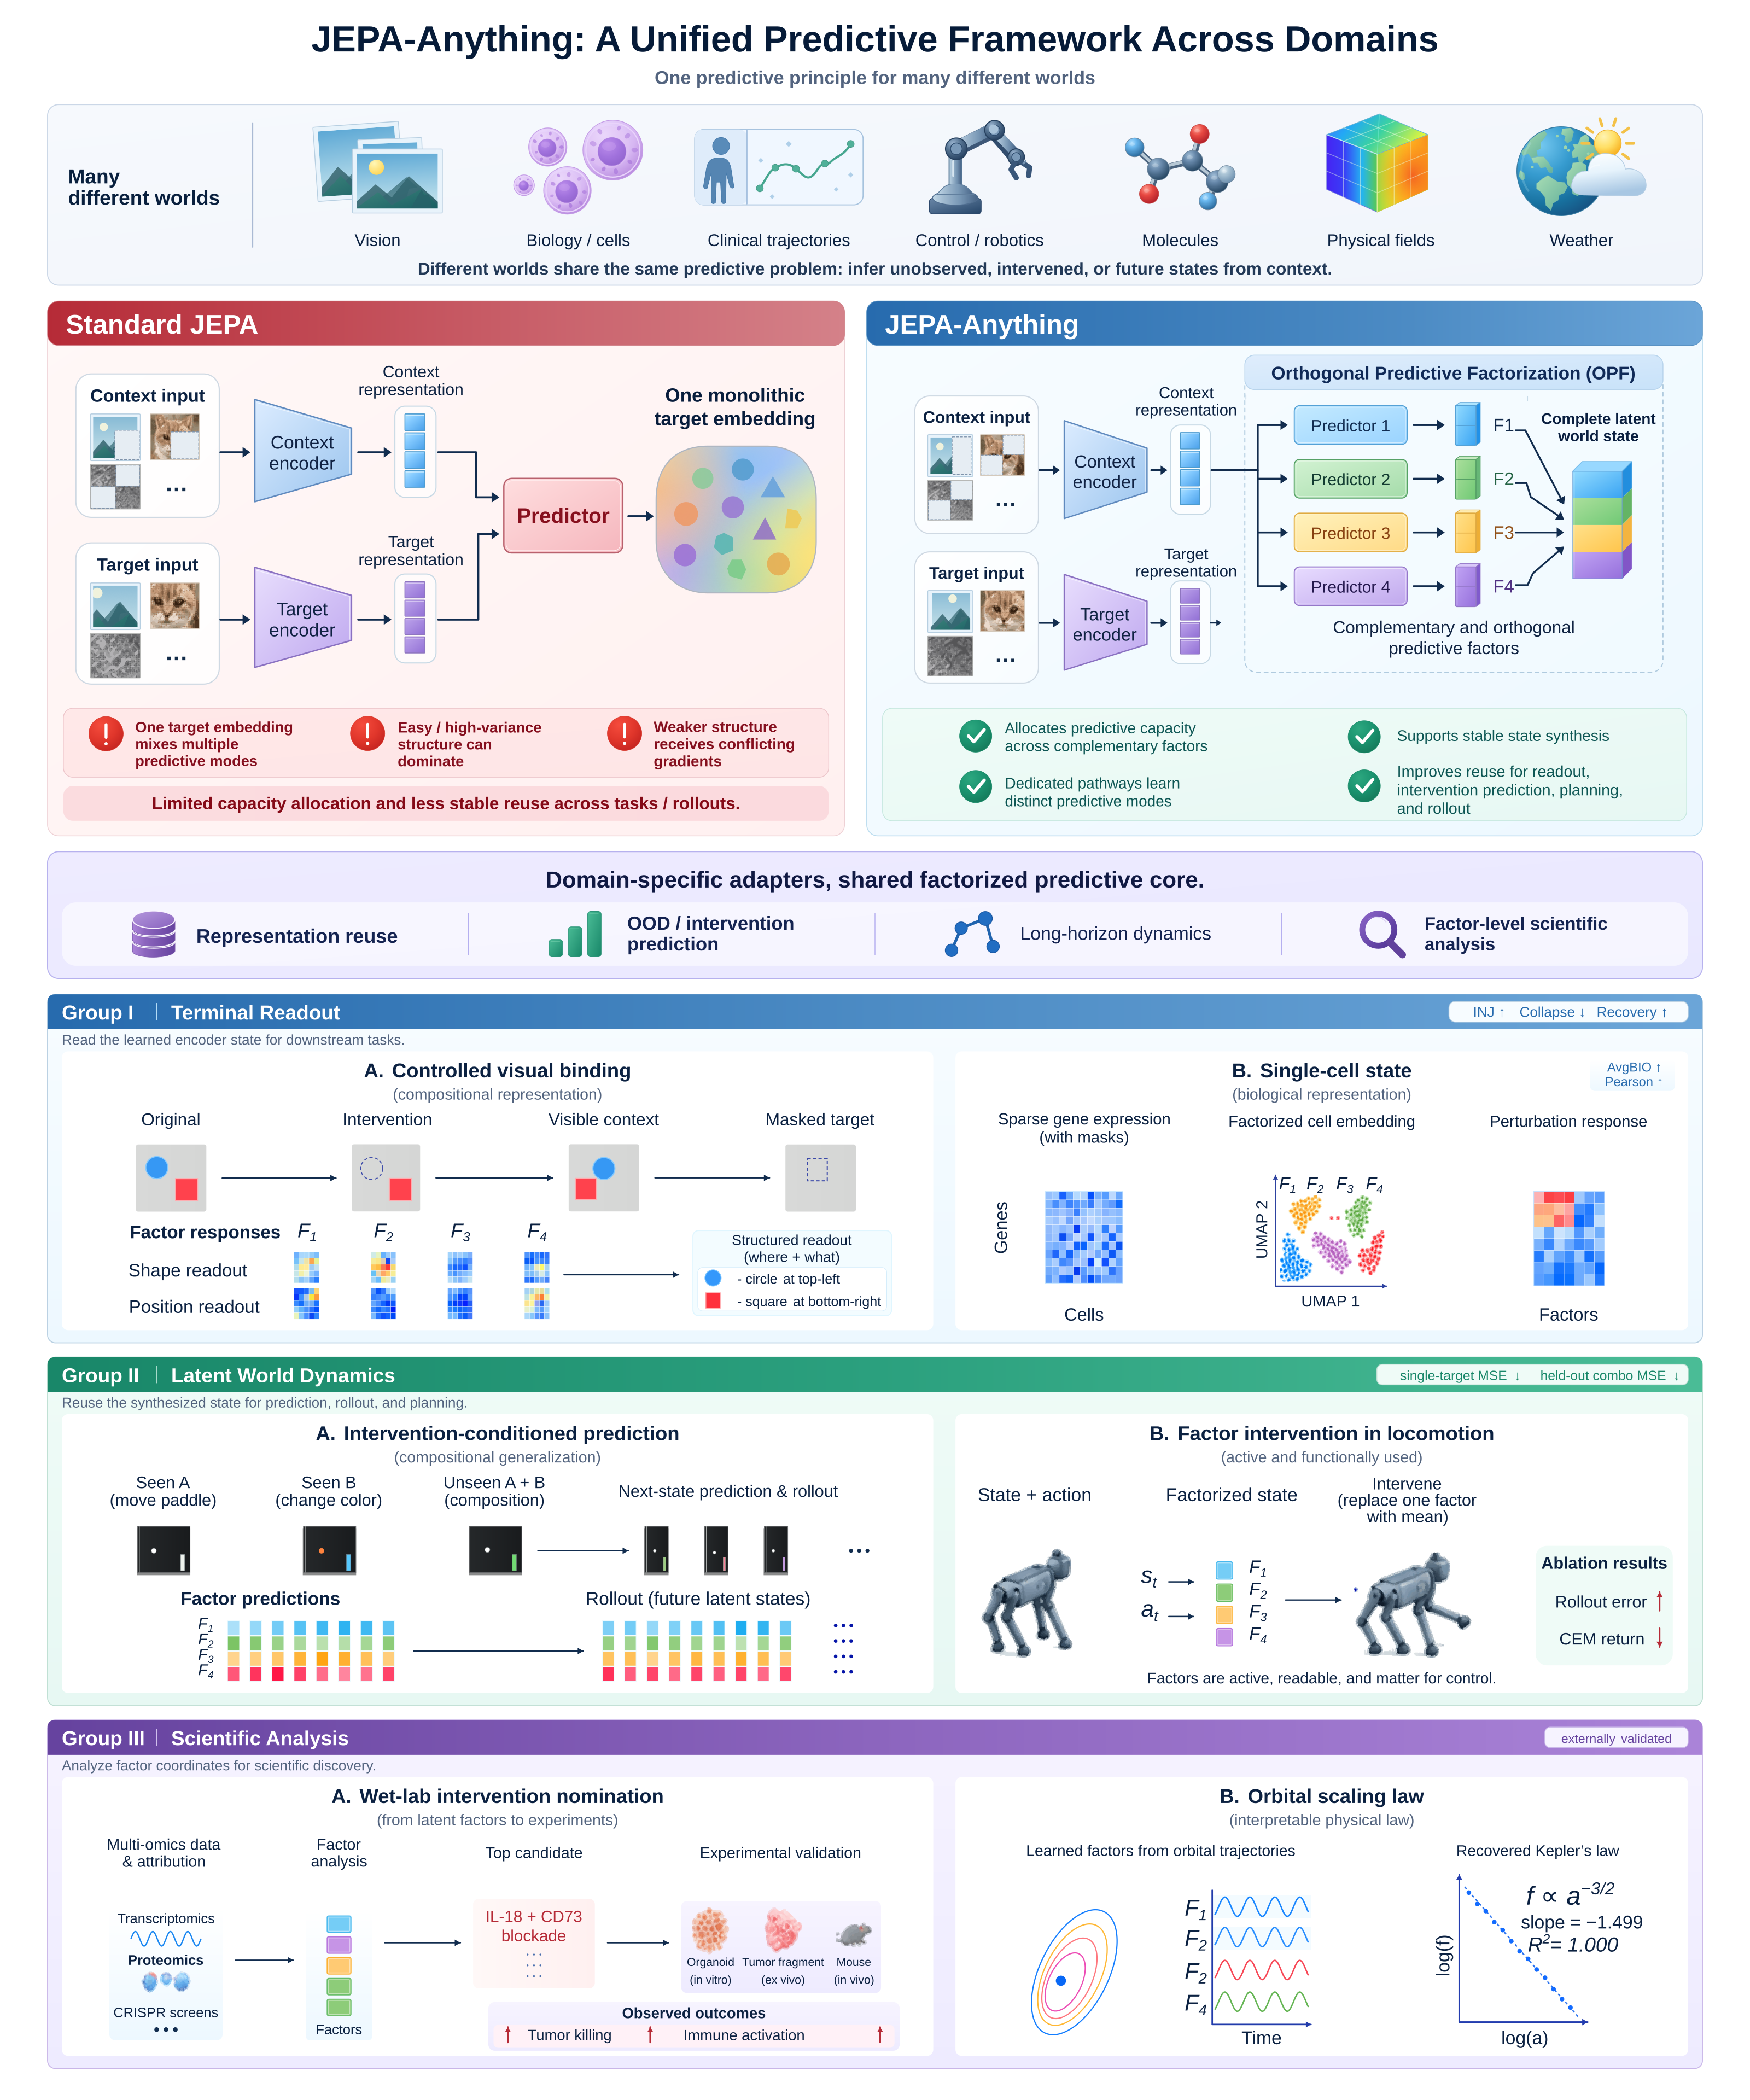
论文问了一个很大的问题:是否存在一个通用的学习原理,能让"世界模型"横跨视觉、生物、临床、控制、分子动力学、物理场和天气这七个完全不同的世界? 作者的回答是 OPF(Orthogonal Predictive Factorization,正交预测分解)——它保留 JEPA 的联合嵌入预测骨架,但把原来单一的整体目标嵌入拆成 K 个正交子空间,每个子空间配一个专属预测器,再用伪逆把各因子合成回一个完整的隐状态。
01 — 30 秒速览
这篇论文到底做了什么
一句话:把 JEPA 里那个"什么都要预测"的整体目标向量,切成 K 块互相正交的、各由专属预测器负责的因子;再用伪逆把预测出的因子合成回一个完整隐状态。 切分不是语义切分(不是"位置/物体/动作"这种人工标签),而是由可预测性自行涌现的空间切分。
一个接口
所有领域都被规约成同一个等式:x → 适配器 → (H, S) → 视图采样器 → (HC, SC, T, ST)。适配器负责"观测几何"(图像 patch 坐标、时间戳、图位置、实体身份),核心只负责"上下文预测目标"。
一个核心
K 个学习到的投影矩阵 Pk ∈ ℝd×r(满足 Kr = d)把停止梯度的目标嵌入切开;K 个预测器从共享的上下文表征分别预测每一块;伪逆负责合成。
三项正则
ℒorth 强制因子内部正交归一、因子之间互相正交;ℒfac 保住每个因子坐标的方差;ℒenc 直接给在线编码器一个反坍缩梯度。三者与基础损失相加。
两种用法
表征模式:丢掉投影器和预测头,只用在线编码器特征接各种下游读出。世界模型模式:保留投影器和预测器,把合成出的完整隐状态当作转移算子,做规划与自回归推演。
三级验证
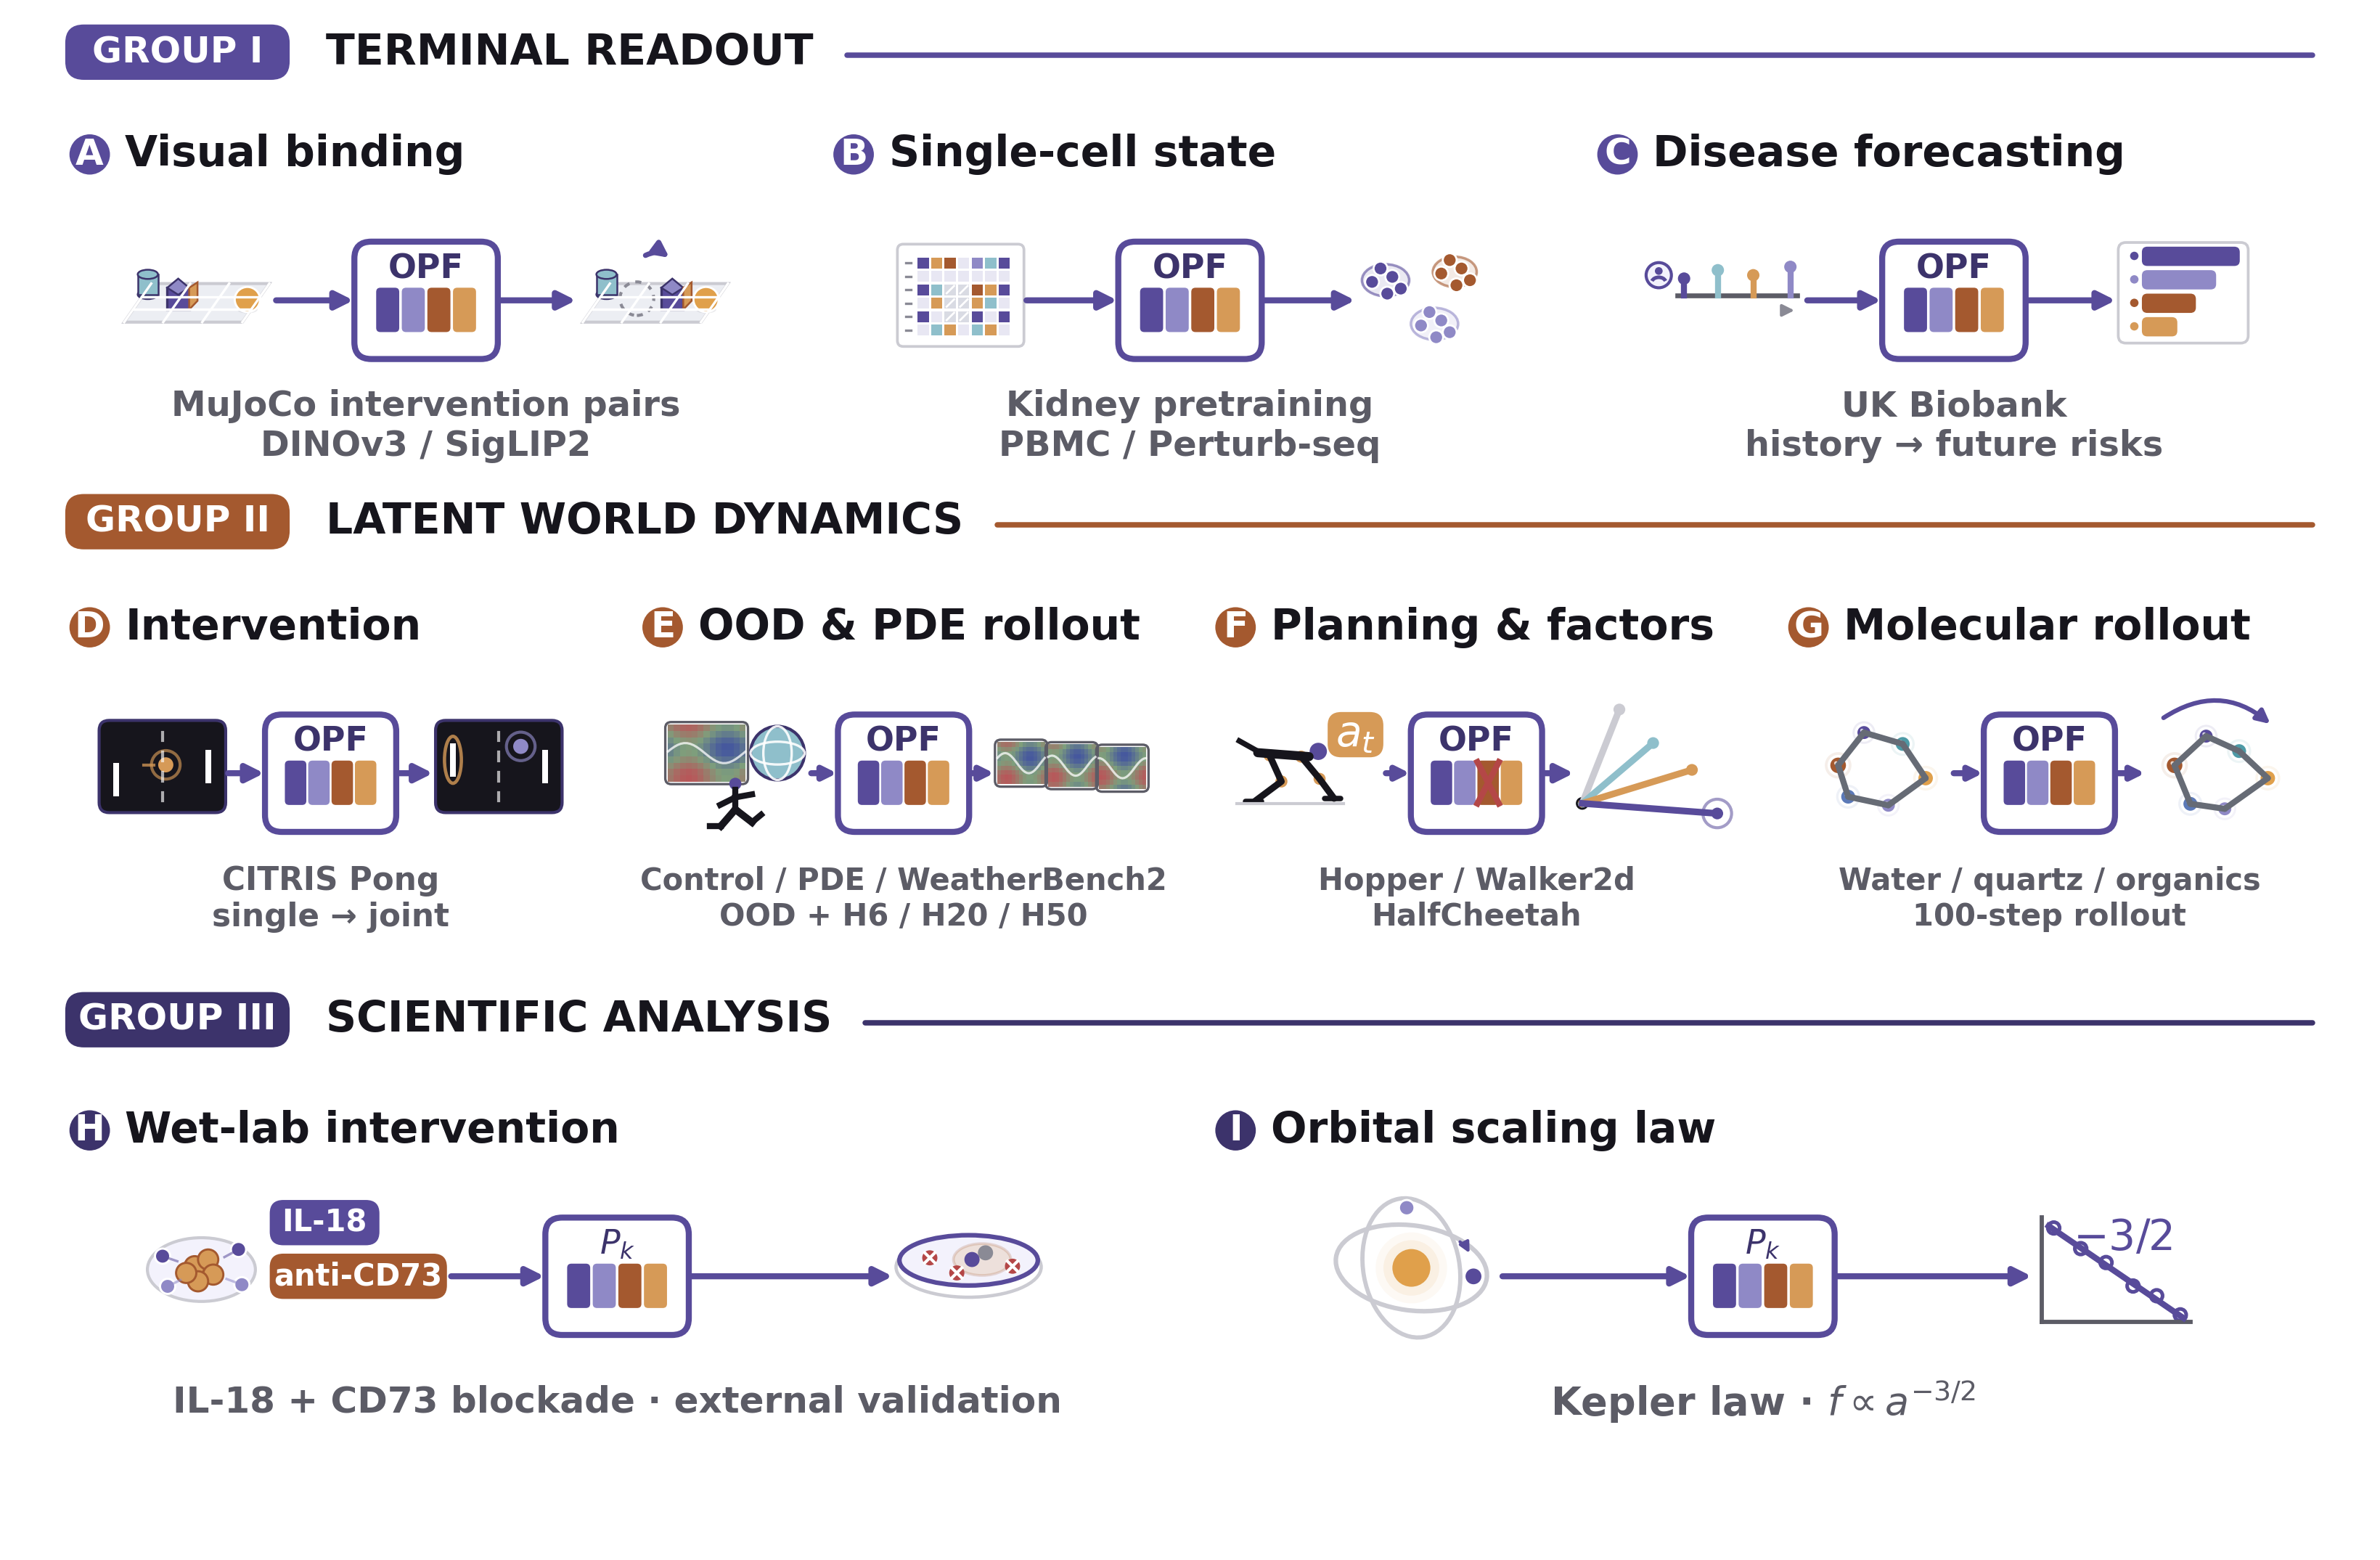
Group I 终止于读出(视觉、单细胞、疾病预测);Group II 递归使用预测状态(干预合成、OOD 长程、控制规划、分子);Group III 把因子坐标当科研接口(湿实验验证、物理定律诊断)。
最出人意料的一点
模型因子坐标提名出的干预组合 IL-18 + NT5E/CD73 阻断,在细胞共培养、患者来源类器官、肿瘤碎片和免疫健全小鼠中获得了实验支持——这是"世界模型 → 可测试生物学假设"的闭环。
过去两年 JEPA 系列(I-JEPA / V-JEPA / V-JEPA 2 / DINO-WM / Cell-JEPA)一直面对同一个隐含问题:目标嵌入是一个整体向量,"预测什么"这件事本身没有被设计。凡是局部结构、全局结构、多实体、多尺度变化挤在同一个目标里,易预测成分或高方差成分就会主导优化,弱的预测结构只能收到互相冲突的梯度。本文把它正式表述为一个 预测容量分配问题(predictive capacity-allocation problem),并给出了一个极简、可加、几乎零成本的解法。
02 — 动机
为什么"整体目标嵌入"是个瓶颈
论文的世界模型定义刻意放宽:不再局限于"动作条件下的控制",而是从上下文构建一个隐状态,并用它预测同一个底层世界的另一个状态。这个"另一个状态"可以是未来状态、被遮挡的空间区域、另一个视角,或者同一系统的更完整观测。患者病史、分子轨迹、部分观测场景、细胞表达谱,全都落进这个定义。
问题在于:不同系统的可预测结构长得完全不同。
- 视觉状态可能同时包含位置、物体身份、变换操作;
- 生物状态可能包含细胞类型与扰动响应;
- 物理状态可能包含实体、尺度、动力学模态。
而这些成分的数量、尺度、可预测难度差异极大,不同下游任务复用的还是不同混合比例。于是当 JEPA 用一个整体嵌入承载全部时,会出现三种病:
① 主导化
易预测或高方差的结构主导优化目标,难以预测但重要的结构被淹没。
② 角色重叠
多个隐方向承担相似角色,容量被冗余占用,信息覆盖不完整。
③ 梯度冲突
较弱的预测结构在共享路径上收到互相矛盾的梯度,学不动也不稳定。
「能否用一个隐世界模型接口,通过多个因子,去组织许多结构迥异的上下文—目标系统的预测状态?」
注意这个提法很讲究:它要求接口固定、状态可组织。也就是说,通用性来自"接口不变",而适应能力来自"状态可以被拆成多个互补分量"——而不是给每个领域写一套新架构。
03 — 方法
正交预测分解(OPF)的内脏
3.1 一个接口,一个预测核心
设 δ 是领域索引,x ~ 𝒟δ 是原始观测。领域适配器 𝒜δ 把 x 映射成内容 token H = {hi}i∈Ω 与结构描述符 S = {si}i∈Ω。描述符可以编码 patch 坐标、时间戳、图位置、实体身份,也可以为空。视图采样器 𝒱δ 选出上下文索引 C ⊂ Ω 和目标索引 T ⊂ Ω,得到统一接口:
在线编码器给出上下文表征 zc = fθ(HC, SC);目标编码器给出每个 t ∈ T 的隐目标 zt = fθ̄(H, S)t ∈ ℝd。目标参数用指数滑动平均更新、且不接收梯度:
当 |T| = 1 时,退化为经典的"单向量"JEPA。论文用一张表把什么随领域变、什么永远不变划得很清楚:
| 组件 | 领域相关边界 | 共享的 JEPA-Anything 核心 |
|---|---|---|
| 原始表征 | 图像、序列、图、集合、记录 | — |
| Token 化与描述符 | 𝒜δ | 公共 token 接口 |
| 上下文—目标语义 | 𝒱δ | 上下文预测目标 |
| 编码器架构 | ViT / Transformer / GNN / MLP … | 在线 + EMA 目标的双塔方案 |
| 预测学习 | — | 因子化预测器与状态合成 |
| 正则化 | — | 正交性、因子活性、编码器方差 |
| 训练目标 | 原实现的损失 ℒbase(δ) | 式 (10) 的可加 OPF 损失 |
| 下游使用 | 池化、读出、探针、解码器、规划器 | 在线编码器特征 或 合成出的预测状态 |
接口成立的前提也被明确写出:目标必须与上下文存在可用的统计依赖,且必须是同一底层系统的另一个状态。因子身份来自预测学习,而不是预定义的语义——这一点后面会反复出现,也是它区别于 β-VAE / Slot Attention 一类工作的关键。
3.2 正交预测分解:切、预测、合
切。引入 K 个可学习投影器 Pk ∈ ℝd×r,取 Kr = d。在零惩罚极限下,这 K 个互相正交的子空间构成目标空间的一个完整划分。对停止梯度的目标表征做分解:
注意梯度的流向:停止梯度只加在目标编码器的输出上,投影器本身是可训练的,从预测项、正交项、因子活性项三处接收梯度。因此学到的子空间既"可预测",又"被正交性约束塑造"。
预测。每个因子 k 有对应的预测器 qk,把共享上下文表征(必要时加上目标描述符 st)映射到同一个 r 维空间:
预测器可以各自独立实现,也可以是共享主干 + 分叉头。当上下文已唯一确定目标时,预测器可以忽略描述符。
合。把各因子预测拼接成 ût = [(ẑt(1))⊤, …, (ẑt(K))⊤]⊤ ∈ ℝd,再经分析映射 P⊤ 的 Moore–Penrose 伪逆合成完整目标状态:
当 P 严格正交时,(P⊤)† = P,式 (5) 退化为极简的 ẑt = Σk Pk ẑt(k)。这个合成状态就是整个框架的公共接口——解码未来隐状态、或是喂回多步推演,都走这一条路。
对时序 / 动作条件 / 干预条件的实例,设 ξt 为第 t 步的外生输入(动作、干预标签、已知外力)。适配器把 ξt 放进上下文 token 或目标描述符。当当前上下文被隐状态 zt 概括时,操作性转移写成:
反复施加即定义隐空间推演(latent rollout)。规划器可以用已知的领域回报或任务特定的回报读出给轨迹打分——这个分工很重要:OPF 负责提供预测状态,应用负责提供回报规范。
预测损失:为什么要直接回归因子
为了让状态合成所需的方向和幅度都保住,论文没有用余弦相似度之类的方向性损失,而是直接对每个预测因子做 L2 回归:
正交损失:因子必须有差异
仅靠预测损失不够——多个投影器完全可能学到同一批目标方向。因此显式要求:每个投影器内部的列近似正交归一,且不同投影器占据近似正交的子空间:
第一项避免因子内部出现退化基,第二项阻止不同因子反复编码同一个方向。论文把它和 SSL 里的冗余削减目标(Barlow Twins、VICReg)类比,但点出关键差别:这里的正交性直接施加在"学习到的预测目标子空间"上,而不是施加在单个嵌入的统计量上。
3.3 保持因子与编码器活性
正交性规定的是子空间之间的关系;还需要一个逐因子的活性下限,保证每个投影坐标在样本间不塌成常数。设 σfack,j 是坐标 j 在 mini-batch 上的经验标准差(因为目标表征被停止梯度,这一项实际塑造的是投影器);另设 σencj 是在线上下文表征的经验标准差。标准差按 √(Var + ε) 计算,得到两个合页损失:
前者让被投影的目标保持活性,后者给在线编码器一个直接的反坍缩梯度。最终把预测项和正则项汇成可加的 OPF 损失,与领域原损失相加:
整个核心是可加的:任何已有的 JEPA 式实现,只要把它原来的预测损失旁边加上 ℒOPF 即可。适配器、视图采样器、编码器家族、输入 token 化都无需改动。这解释了为什么它能一次性铺到七个领域——不是为每个领域设计新架构,而是所有领域共用一个可加的正则项。
3.4 同一套预训练,两种使用模式
所有实例遵循同一个优化循环:① 适配原始观测为 token 与描述符 → ② 采样上下文与目标 → ③ 用在线编码器编码上下文、用停止梯度的 EMA 编码器编码目标 → ④ 预测每一个正交目标因子 → ⑤ 用式 (10) 更新在线编码器、投影器和预测器 → ⑥ EMA 更新目标编码器。
表征模式(Representation)
普通下游评测:保留在线编码器作为可复用特征的公共来源,接一个符合领域与任务结构的读出。EMA 目标编码器、投影器和预测头全部丢弃。
Rδ,τ 可以是选 token、对集合或序列池化、保留时间索引状态,或一个可学习探针。OPF 在这里扮演的是"塑造可复用编码器的共享训练原理",聚合规则仍由各模态自定。
操作性世界模型模式(Operational)
面向未来状态预测、干预预测、规划、自回归仿真:保留投影器和预测器。式 (5) 把完整的下一步隐状态交给解码器、规划器或下一个转移步。
同一套预训练原理因此支持两种用途:可复用编码器特征用于状态读出;显式隐转移接口用于跨时间组合的预测。
在因子级分析里,学习到的投影器被保留下来当作诊断接口,直接暴露可解释的预测模式——这正是 Group III 做湿实验提名和轨道谱分析所依赖的接口。
04 — 交互
亲手拆一次:正交性究竟在保护什么
下面这个二维示意(d = 2, K = 2, r = 1)复现了论文 Proposition 1 与 Corollary 1 的几何。 拖 "因子间夹角偏离" 让两个因子从正交逐渐变成"几乎重复的方向",看条件数 κ₂(P) 怎么爆掉、合成误差怎么被放大——这就是论文 Table 5 里"无约束多头"与"正交分解"拉开 5 个数量级的原因。
读数说明:严格正交时 (P⊤)† = P,实测误差精确等于 ‖e‖,且 κ₂(P) = 1。 一旦因子方向重叠,伪逆必须"用一个小奇异值去除",误差被放大 1/σ_min 倍——论文的 Corollary 1 正是说:无约束多头没有任何一致保证,可能出现秩亏(信息丢失)或条件数无界(合成爆炸)。
这个演示是二维广义示意,用于直观呈现正交性的几何作用,不等价于论文的 d=160、K=5 实测设置(Table 5)。论文实测值:无约束多头的交叉重叠 0.455、σ_min = 0.00513、κ₂ = 438.52;正交分解后分别是 5.18×10⁻¹⁶、0.999989、1.00005。
05 — 理论
两条命题:完整覆盖 + 稳定合成
论文的理论部分很轻,但正好卡在要害上:它要证明的不是"解耦更优雅",而是"这么切不会丢信息,且合回来不会放大误差"。
Proposition 1(正交预测分解)
若 Pi⊤Pj = 0 (i ≠ j) 且 Pk⊤Pk = Ir,则因子空间构成正交直和,且对任意 z ∈ ℝd:
换言之:因子保留 z 的全部信息,只差一个正交基变换。在这个零惩罚极限下,式 (5) 的伪逆合成退化为对应的正交合成规则。这一条回答了"切了会不会漏"。
Corollary 1(稳定合成 vs. 无约束头)
记 u = P⊤z,e ∈ ℝd 为拼接后的因子预测误差。在 Proposition 1 的假设下:
而去掉交叉因子正交约束后:存在允许的投影器(含重复方向)使 P 秩亏;也存在满秩但方向"近似重复"的投影器,使 P 的条件数任意大。因此无约束多头既不能保证完整恢复,也不能保证稳定合成。这一条回答了"为什么必须正交,而不是随便切几块"。
Proposition 2(近似稳定性,附录 A)
真实训练里 P 只是近似正交,合成走伪逆。若 ‖P⊤P − Id‖2 ≤ ε < 1,则
且对精确因子坐标 u = P⊤z 与预测坐标 û = u + e:
伪逆合成对精确的因子坐标没有重建偏差;而实测的正交性残差恰好控制了因子预测误差的放大倍率。换句话说,训练时的 ℒorth 不只是一个"让表示好看"的正则项,它直接决定了运行时状态合成的数值稳定性。论文在 Table 5 里用真实训练模型报告了这些性质。
补充:论文在严格正交分解的推导里用 Praw = QR(Q⊤Q = Id)因子化,分区为 Q = [Q1, …, QK],从而坐标 Qk⊤z 满足转置合成 z = QQ⊤z = Σk QkQk⊤z。受控几何分析用这个严格分解;实际预测模型用学习到的、被正交正则化的投影器 + 伪逆合成。
06 — 实验
三级验证:从读出到滚到湿实验
实验组织本身就是一个论点:Group I 验证"预测出的状态能读出东西";Group II 验证"预测出的状态能被反复使用而不崩溃";Group III 验证"因子坐标能当科研接口,接通外部证据"。三组递进,缺一组论证都不成立。
统一的对照逻辑:所有定量比较都同时包含①领域标准基线、②整体式(monolithic)JEPA 基线、③JEPA-Anything。在与标准 JEPA 的直接对照中,适配器、编码器架构、上下文—目标采样器、优化预算、数据划分、下游读出、继承的基础损失全部固定;标准 JEPA 加它的整体预测项,JEPA-Anything 加 ℒOPF(含因子专属正则)。这意味着性能差异只能归因于因式化本身,而不是参数量或算力的偷偷增加。这一点在后面控制实验里有精确的参数量/FLOP 核对。
Group I · 预测世界状态的终端读出
状态被用一次,终止于读出
3.2.1 受控视觉绑定(Controlled Visual Binding)
问题:冻结的表征能否同时保留"变化发生在哪里"和"发生了哪种操作",包括读出训练时被扣掉的支撑—操作组合?
设置:DINOv3 ViT-S(d = 384,K = 4, r = 96)与 SigLIP2 Base(d = 768,K = 4, r = 192)。冻结基线直接用原检查点。标准 JEPA 与 JEPA-Anything 从完全相同的副本出发,用块掩码 patch 预测 + 二维位置描述符训练,共享数据、掩码、优化设置和读出架构。训练后的编码器被冻结,用于受控干预评测。评测在重建的 MuJoCo 场景上做图像不相交划分、留一单元(leave-one-cell-out)读出和单射匈牙利对齐,报告 10 个种子的 INJ(单射留出单元准确率)、Coll.(阈值 0.5 的坍缩率)、Rec.(网格恢复率)。
| 骨干 | 编码器预训练 | 网格监督 | INJ ↑ | Coll. ↓ | Rec. ↑ |
|---|---|---|---|---|---|
| DINOv3 | 冻结检查点 | 已知网格 | .452 | .667 | — |
| DINOv3 | 冻结检查点 | 学习网格 | .569 | .433 | .643 |
| DINOv3 | 标准 JEPA | 学习网格 | .572 | .426 | .645 |
| DINOv3 | JEPA-Anything | 学习网格 | .581 | .417 | .659 |
| SigLIP2 | 冻结检查点 | 已知网格 | .476 | .656 | — |
| SigLIP2 | 冻结检查点 | 学习网格 | .484 | .511 | .676 |
| SigLIP2 | 标准 JEPA | 学习网格 | .483 | .514 | .679 |
| SigLIP2 | JEPA-Anything | 学习网格 | .490 | .503 | .688 |
注意"冻结检查点 → 标准 JEPA"这一步在 SigLIP2 上几乎没变化(.484 → .483),而 JEPA-Anything 再进一步提升到 .490。增益幅度不大——这是论文里最弱的一组证据之一,值得在后面第 7 节单独讨论。
3.2.2 单细胞状态表征与扰动预测
问题:scRNA-seq 每个细胞是一个高维但极度稀疏的表达谱,逐基因重建会把容量浪费在技术性 dropout 和计数波动上。隐预测能否学到更稳定的细胞状态表征?正交分解能否进一步改善细胞类型聚类和扰动响应预测?
设置:跟随 Cell-JEPA 的构建设置,用 scGPT 骨干,按基因身份 + 离散化表达值做 token 化。表征路径是掩码构造:学生编码器接收掩码表达值,预测 EMA 教师从未掩码细胞给出的细胞级嵌入。Norman 扰动实验预测隐响应 zresponse := zobserved − zcontrol,512 维响应表征用 K = 4, r = 128。评测:约 80 万个人肾细胞上预训练;PBMC-10K 细胞类型聚类(微调与零样本两种设置);Adamson 与 Norman 数据集上的扰动响应预测。AvgBIO 概括聚类质量,Pearson 相关衡量绝对扰动后表达预测。全部为 5 个训练种子平均。
| 模型 | 用 JEPA | 用正交因子 | PBMC 微调 AvgBIO ↑ | PBMC 零样本 AvgBIO ↑ | Norman Pearson ↑ | Adamson Pearson ↑ |
|---|---|---|---|---|---|---|
| scGPT | 否 | 否 | 0.7531 | 0.5288 | 0.631 | 0.905 |
| Cell-JEPA | 是 | 否 | 0.7830 | 0.7194 | 0.787 | 0.937 |
| JEPA-Anything | 是 | 是 | 0.8301 | 0.7752 | 0.814 | 0.942 |
这是四组指标全面最高,且提升幅度可观(零样本 AvgBIO 0.7194 → 0.7752,+7.8%)。审计上也比较干净:Cell-JEPA 与 JEPA-Anything 的差别只有"是否对同一目标做因式化隐预测"。
3.2.3 纵向疾病状态预测
问题:纵向健康记录稀疏、时间不规则,且只部分观测驱动疾病进展的生理状态。预测未来的隐健康状态,能否支撑广谱且长程的临床事件预测?
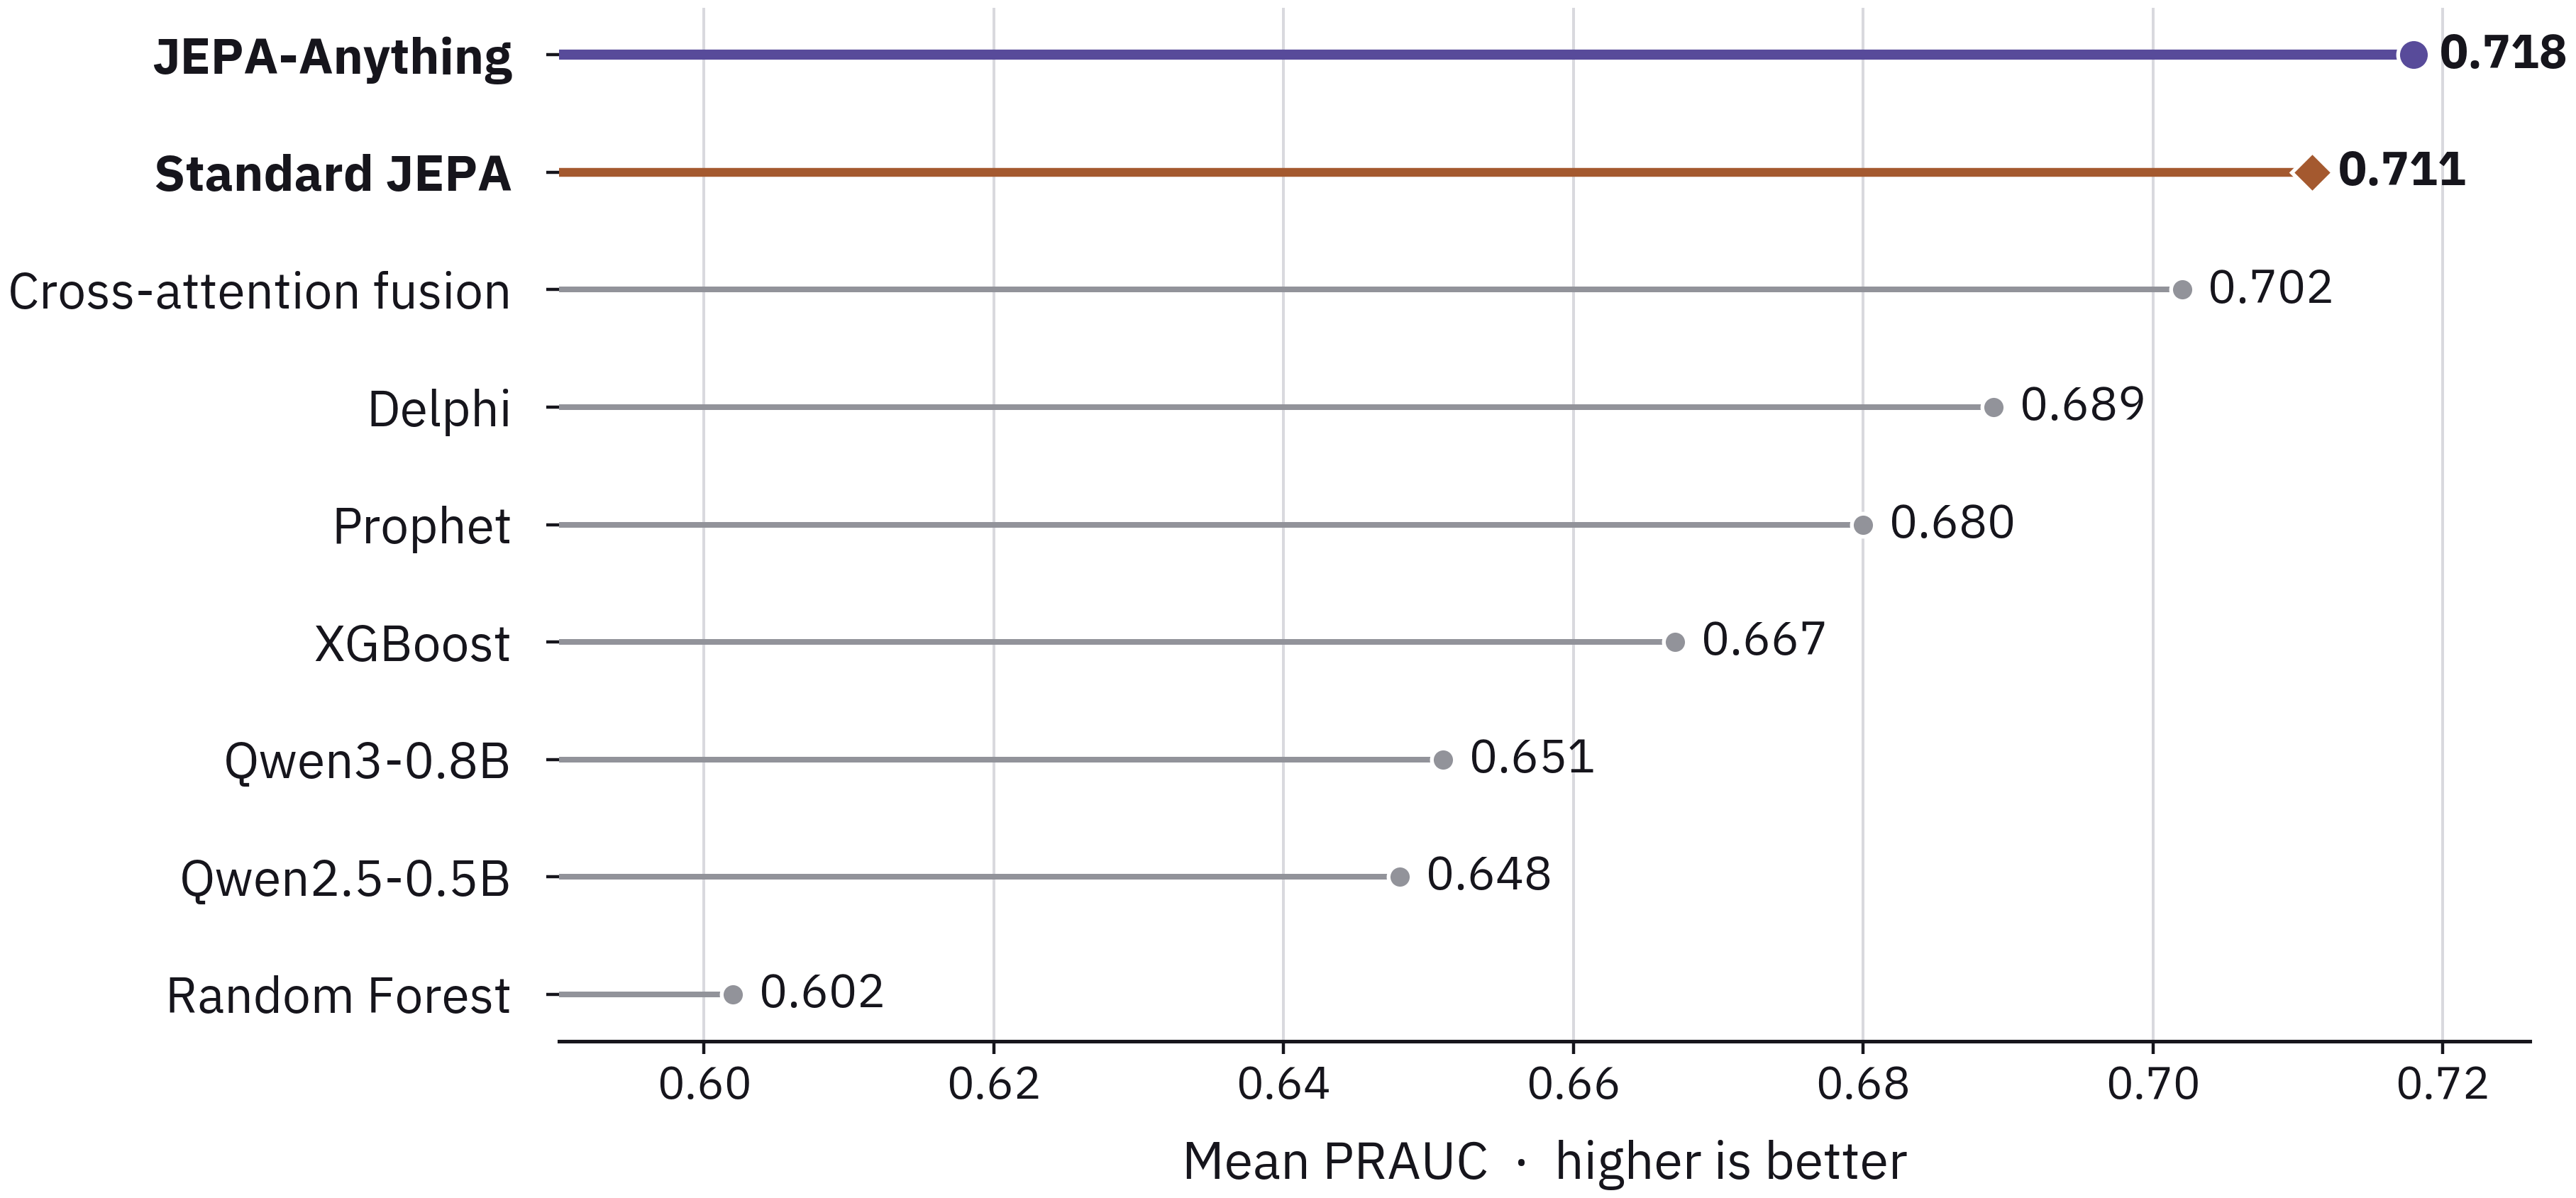
设置:每个患者状态 = 按时间排序的临床事件 + 人口学上下文 + 分子/生化变量。上下文编码器及其 EMA 目标副本使用 GPT-2 small(d = 768),前者表示既往史,后者表示未来患者状态。K = 4, r = 192。对照组是整体式健康状态 JEPA。JEPA-Anything 预测正交因子并用式 (5) 重建完整未来状态,再由一个共享轻量解码器映射到 1000+ 个未来临床事件的风险。主指标是全事件词表上的平均 PRAUC(因为很多结局是稀有事件)。5 个种子,固定患者级队列划分,使用去标识化的 UK Biobank 数据。
Group II · 隐世界动力学与推演稳定性
状态被反复使用,表征误差变成动力学误差
3.3.1 干预条件下的组合式预测
关键区分:在 CITRIS Interventional Pong 里,干预不是模型选择的动作。实验者改变系统的一个或多个因子,模型同时收到干预前观测和一个说明"改了什么"的标签,任务是预测随之而来的下一个状态。
两级泛化:① 训练分布内出现过的单因子干预;② 多个因子同时被干预,且这个组合在训练中被扣掉——尽管每种单独变化都见过。第二级真正在问:模型是记住了完整的干预模式,还是能在新的组合配置下重组已学到的状态变化规则?此外还评测六步自由推演。
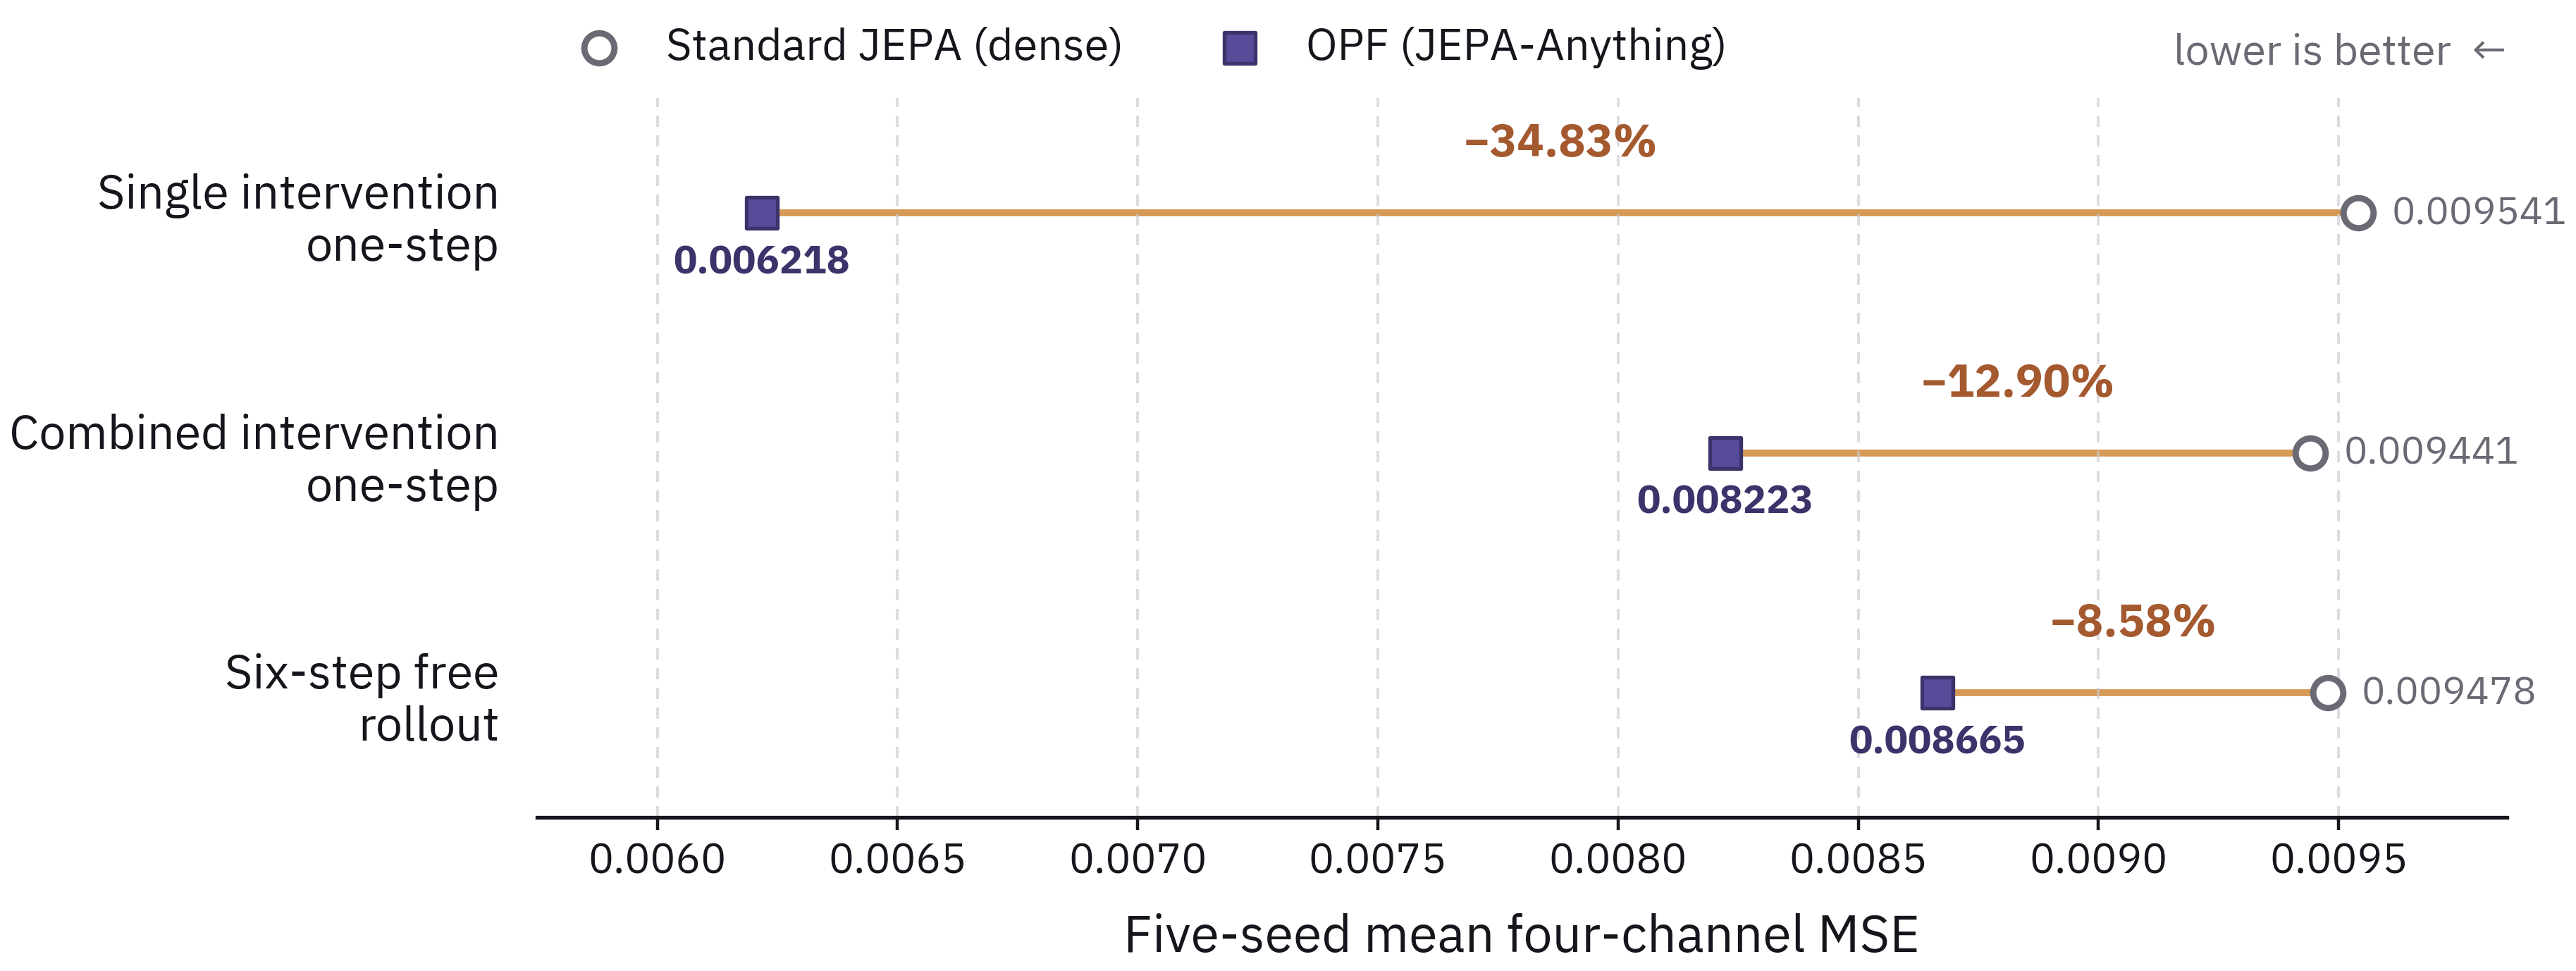
| 条件 | 标准 JEPA | JEPA-Anything | 变化 |
|---|---|---|---|
| 单干预 · 一步 MSE | 0.009541 | 0.006218 | −34.83% |
| 组合干预 · 一步 MSE | 0.009441 | 0.008223 | −12.90% |
| 六步自由推演 MSE | 0.009478 | 0.008665 | −8.58% |
5 个配对种子,相同数据、相同模型预算。四通道 MSE,越低越好。注意增益随难度递减:单干预 −34.8% → 组合干预 −12.9% → 六步推演 −8.6%。越往"真正需要泛化"的地方走,增益越小——这个趋势在整篇论文里反复出现。
正交性机制审计(Mechanism Audit)
为了把正交性的结构作用单独分离出来,论文在官方 CITRIS 数据、5 个训练种子、2500 步预算下,把因子接口与容量匹配的无约束多头做对照。审计要回答四件事:因子块是否互相重叠?合并后的分析矩阵是否以稳定的奇异值覆盖状态空间?原始隐状态能否直接从因子坐标合成?以及这种结构是否以"关掉大部分因子"为代价获得?
| 指标 | 无约束多头 | 正交分解 |
|---|---|---|
| 交叉因子子空间重叠 ↓ | 0.4550 ± 0.0420 | (5.18 ± 0.34)×10⁻¹⁶ |
| 最小奇异值 σmin(P) ↑ | 0.00513 ± 0.00233 | 0.999989 ± 0.000003 |
| 条件数 κ₂(P) ↓ | 438.52 ± 170.00 | 1.00005 ± 0.000004 |
| 转置合成 NMSE(精确因子)↓ | 0.7886 ± 0.0299 | (2.98 ± 0.11)×10⁻¹⁴ |
这是全文最干净的一组证据:无约束多头的合成 NMSE 是 0.7886(也就是说,即便给它精确的因子坐标,合回来的状态也错得离谱),而正交分解是 10⁻¹⁴ 量级(数值精度)。条件数从 438 降到 1.00005。这组数据把 Corollary 1 从"存在性证明"变成了实测量。
3.3.2 分布外与长程动力学
两个能力要求:① 从有限轨迹学到可复用的转移规则,而非记住训练轨迹——在未见初始条件、留出回合、更晚时段上预测;② 连续六步前向,每步预测都成为下一步输入,误差会复合。
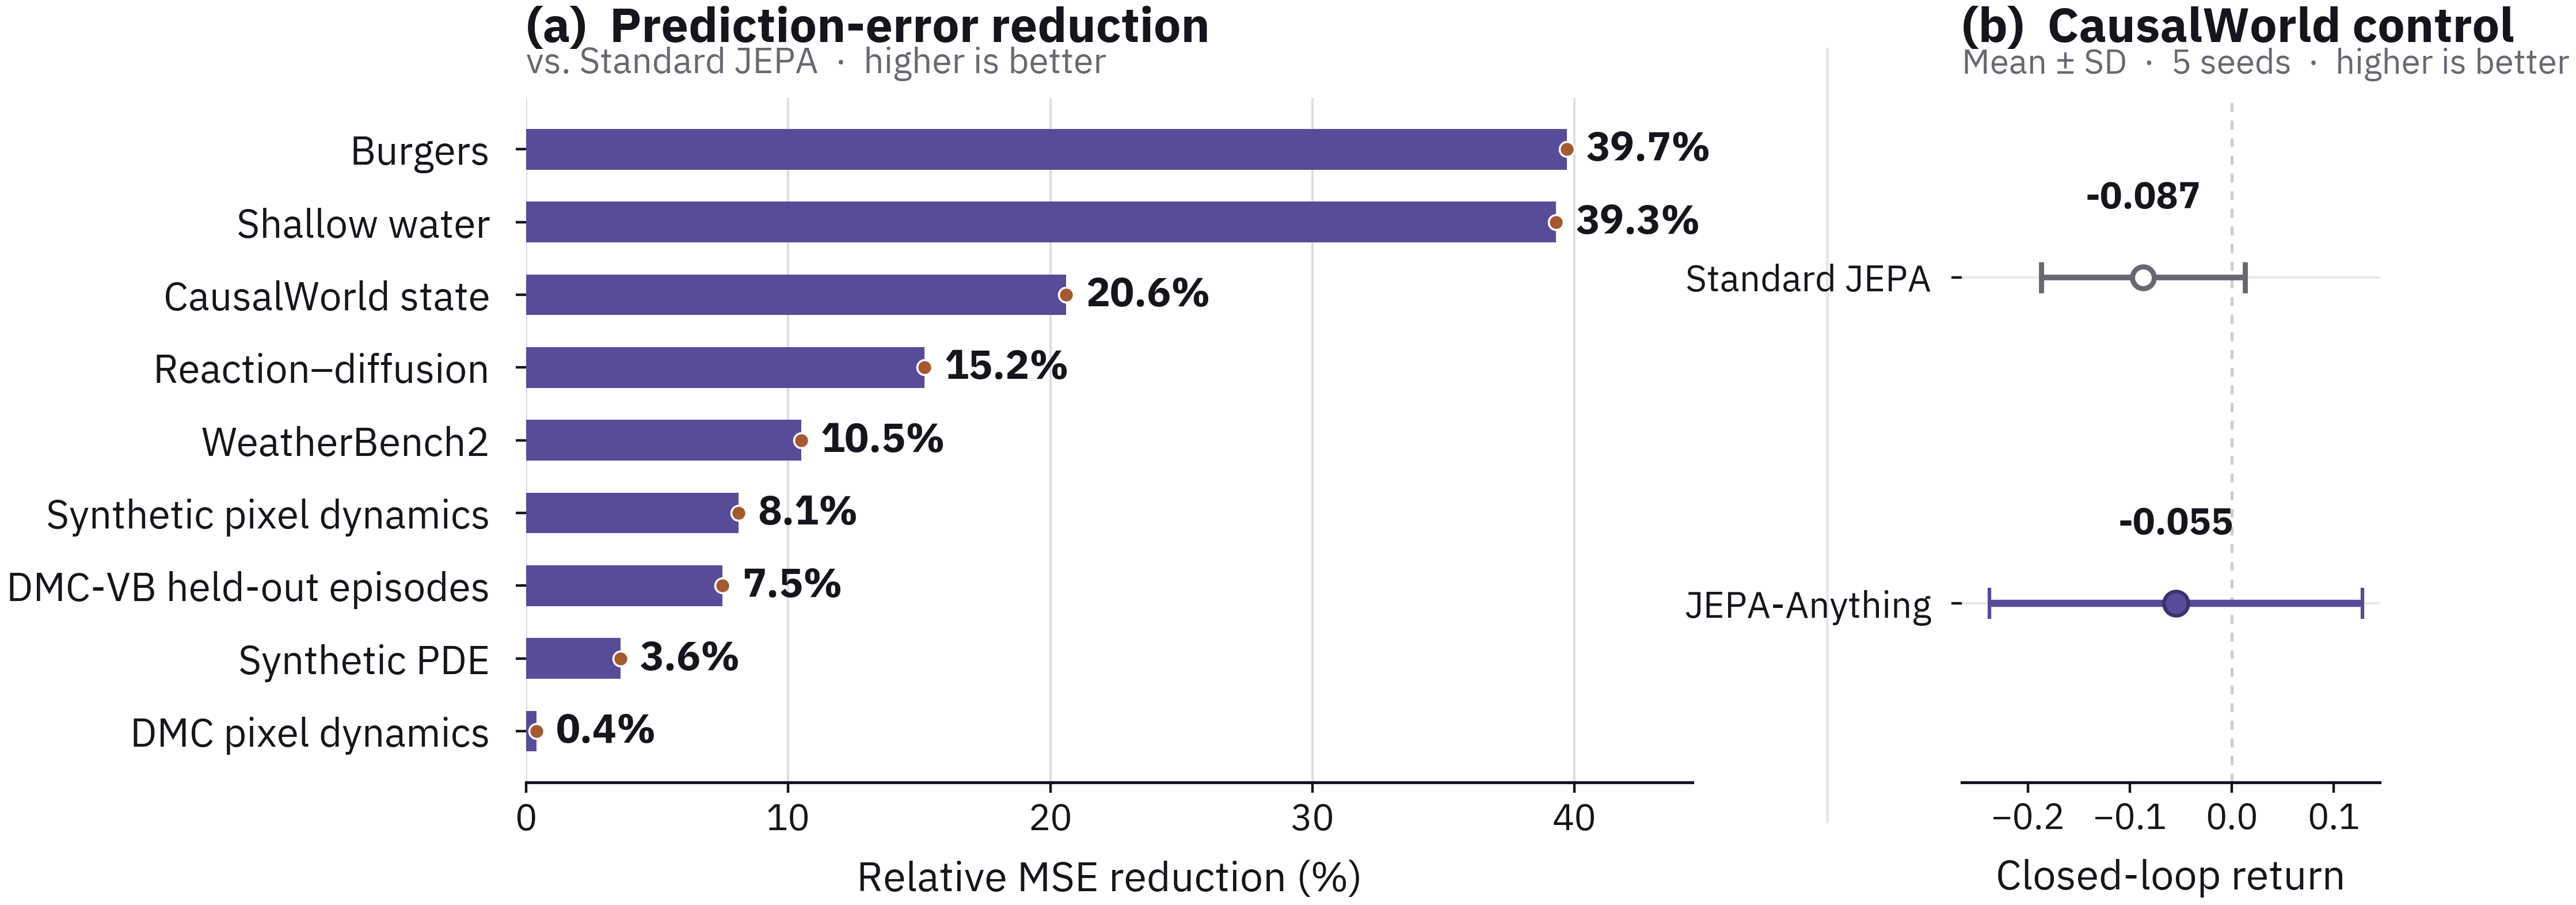
设置:CausalWorld(机器人状态与控制条件观测)、DeepMind Control Suite(像素动力学)、PDEBench(连续物理场)、WeatherBench2(天气场)。10 个任务 × 5 个随机种子 {11, 23, 37, 53, 71}。标准 JEPA 用一个共享隐目标,JEPA-Anything 把目标分成四个因子;同一任务同一种子内,两者使用相同数据、编码器与转移骨干、优化预算、评测划分与计算后端。
| 任务 | 标准 JEPA | JEPA-Anything | ||
|---|---|---|---|---|
| 第 1 步 | 第 6 步 | 第 1 步 | 第 6 步 | |
| CausalWorld 状态预测 | 0.01306 | 0.01307 | 0.01037 | 0.01079 |
| DMC 像素动力学 | 0.008539 | 0.008594 | 0.008498 | 0.008526 |
| PDEBench Burgers | 0.001830 | 0.006369 | 0.001101 | 0.004014 |
| PDEBench 浅水方程 | 0.007090 | 0.010510 | 0.003999 | 0.006522 |
MSE 越低越好,每项为 5 个种子平均。可以看到两类情形:CausalWorld 与 DMC 像素动力学是"低位小幅改善",PDEBench 是"近半折半"的大幅改善——改进幅度与任务本身的结构化程度强相关。
补充评测 A · APEBench 上的 Burgers 与 Kuramoto–Sivashinsky
按 APEBench 的自回归 PDE 协议额外评测 Burgers 与 KS 动力学。因为 APEBench 与 PDEBench 使用不同归一化,结果分开报告。模型用 MLP,第一层线性权重形状 256×64,OPF 维度 d = 128, K = 4, r = 32,5 个配对种子。
| 系统 | 指标 ↓ | 标准 JEPA | JEPA-Anything |
|---|---|---|---|
| Burgers | 留出晚期 MSE | 0.16621 ± 0.01740 | 0.08389 ± 0.01770 (−49.5%) |
| Burgers | 六步推演 MSE | 0.29186 ± 0.00682 | 0.16153 ± 0.03500 (−44.7%) |
| Kuramoto–Sivashinsky | 留出晚期 MSE | 1.1012 ± 0.0763 | 0.9558 ± 0.0340 (−13.2%) |
Burgers 在留出晚期段降低约 49.5%、六步推演降低约 44.7%,每一个种子都改善;KS 晚期预测提升约 13.2%,也是每个种子都改善。论文认为这把改进扩展到了混沌非线性动力学。
补充评测 B · 容量匹配的 Burgers 50 步长推演
一个参数匹配的 50 步协议。两者使用相同的 1 维周期粘性 Burgers 数据,64 个网格点,ν = 0.01,3 个种子,在分布内与高频 OOD 轨迹上评测。仿真器输入维度 xdim = 1024,MLP 隐宽 256,隐状态 d = 128 分为 K = 4 个宽 32 的因子,堆叠投影器形状 (4, 128, 32),训练 2000 步。
| 划分 | 标准 JEPA H20 / H50 | JEPA-Anything H20 / H50 | 相对变化 |
|---|---|---|---|
| 分布内 ID | 1.1185 / 0.8181 | 1.0532 / 0.7923 | −5.84% / −3.15% |
| 高频 OOD | 1.0649 / 0.8452 | 1.0116 / 0.8214 | −5.01% / −2.82% |
优势在两个划分、两个时间尺度上都保持(包括高频 OOD),但从 H20 到 H50 明显收窄(−5.84% → −3.15%)。论文也标注了这一点。这是一个诚实的报告,但也提示:因式化的收益会随推演长度衰减。
在九个带路由统计的预测任务上,JEPA-Anything 平均使用 3.782 个有效因子(共 4 个),平均主导因子占比 0.324。这说明:四个分支是分布式活跃的,而不是"一个干活三个陪跑"。这直接回应了"切了但只有一块有用"的合理怀疑。
3.3.3 连续控制规划
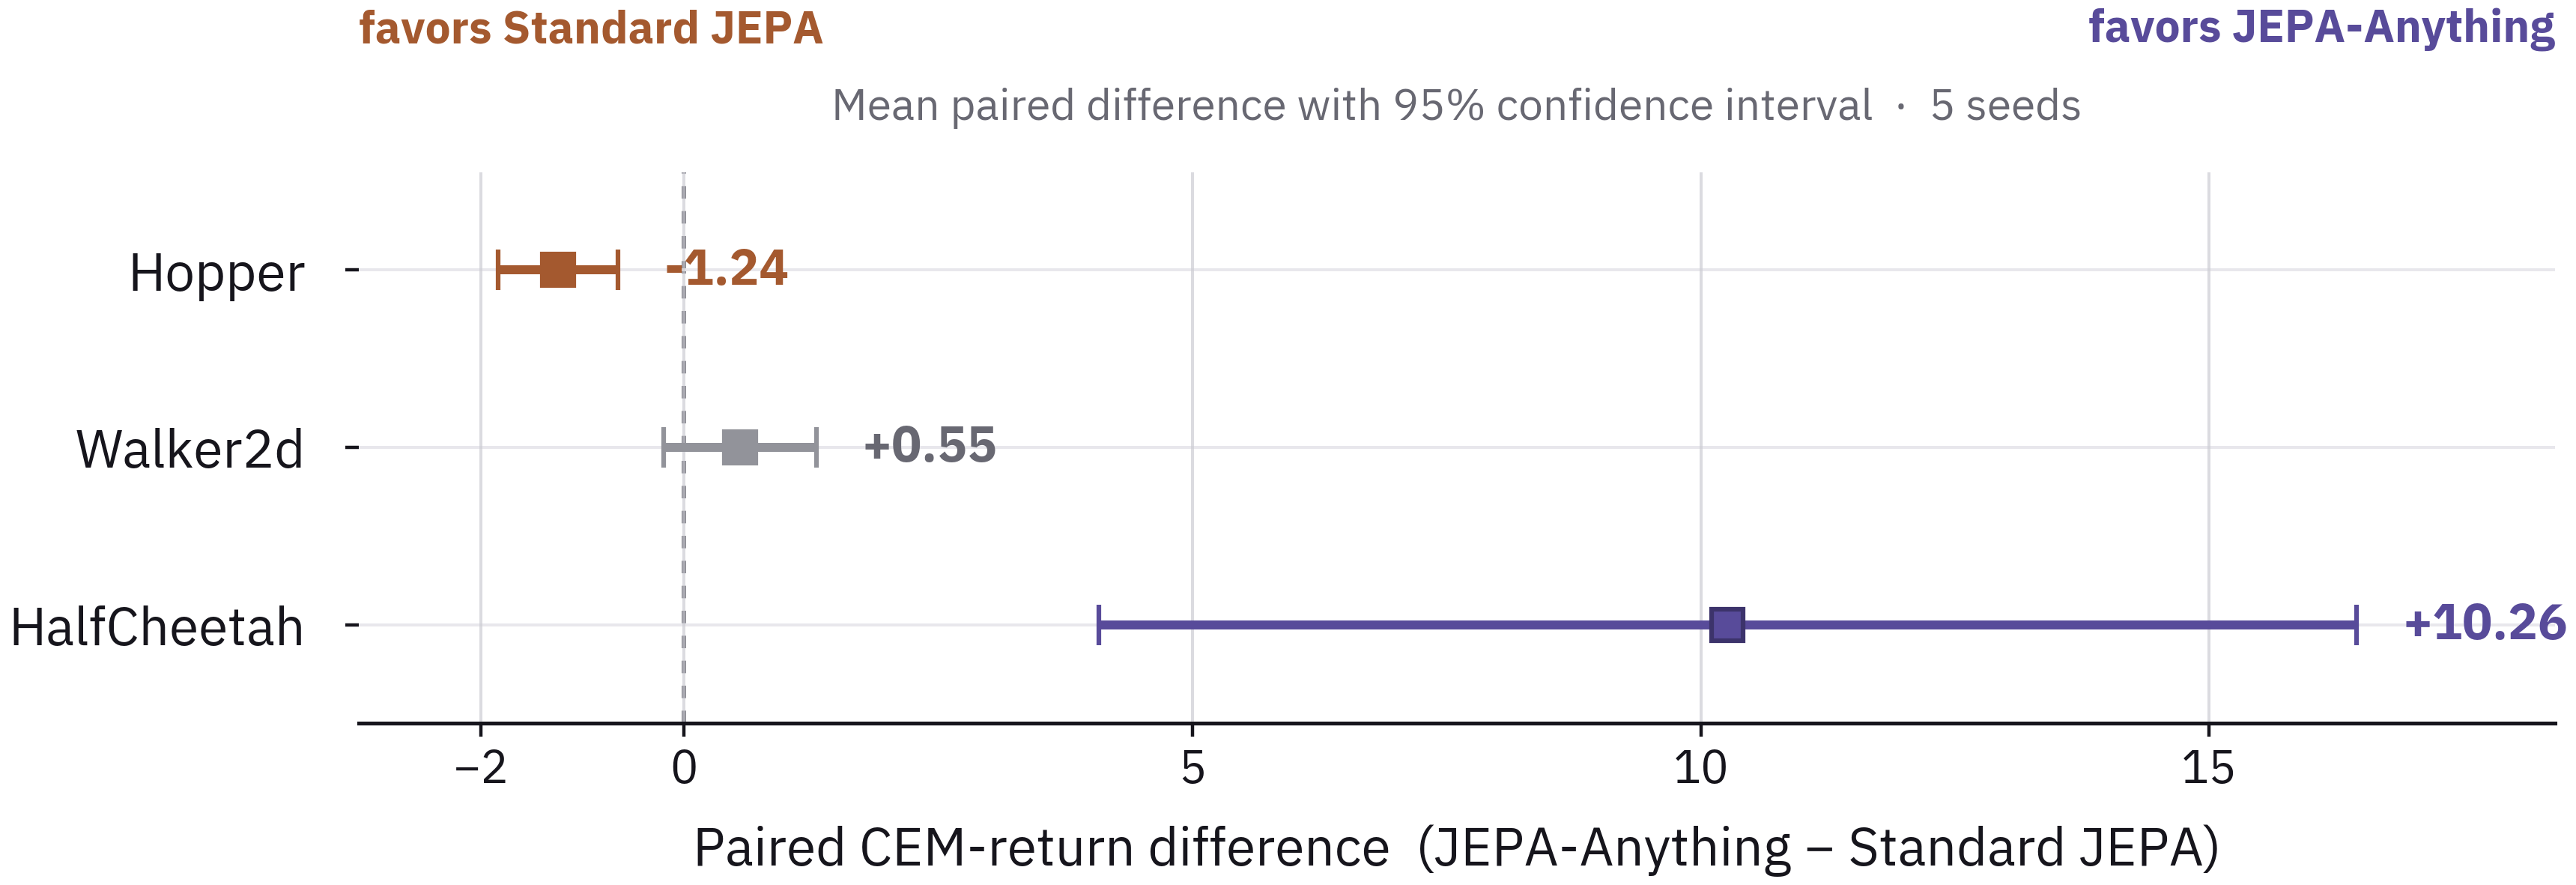
设置:Hopper-v5、Walker2d-v5、HalfCheetah-v5。稠密、容量匹配的标准 JEPA 与全量 JEPA-Anything(K = 4)使用相同数据、骨干、优化预算与评测协议。训练种子 {42, 123, 456, 789, 2026}。每个检查点在 5 个相同环境重置上评测,配对比较会重置 CEM 候选动作的随机性,最终使用真实环境中获得的回报。
参数量核对:分支宽度按 K ∈ {1, 2, 4, 8} 校准。相对稠密标准 JEPA,训练参数量差异为 0.000% / 0.006% / 0.126% / 0.246%,预测头 FLOP 差异为 0.000% / 0.742% / 0.992% / 1.449%——全部低于 0.3% 参数与 2% FLOPs。
JEPA-Anything 在 Walker2d 与 HalfCheetah 上平均 CEM 回报更高,但 Hopper 上标准 JEPA 更好。论文自己的结论是"规划性能依赖环境"(environment-dependent)。这是一个如实的负面结果,不是被粉饰的。
3.3.4 运动控制中的因子活性与功能性干预
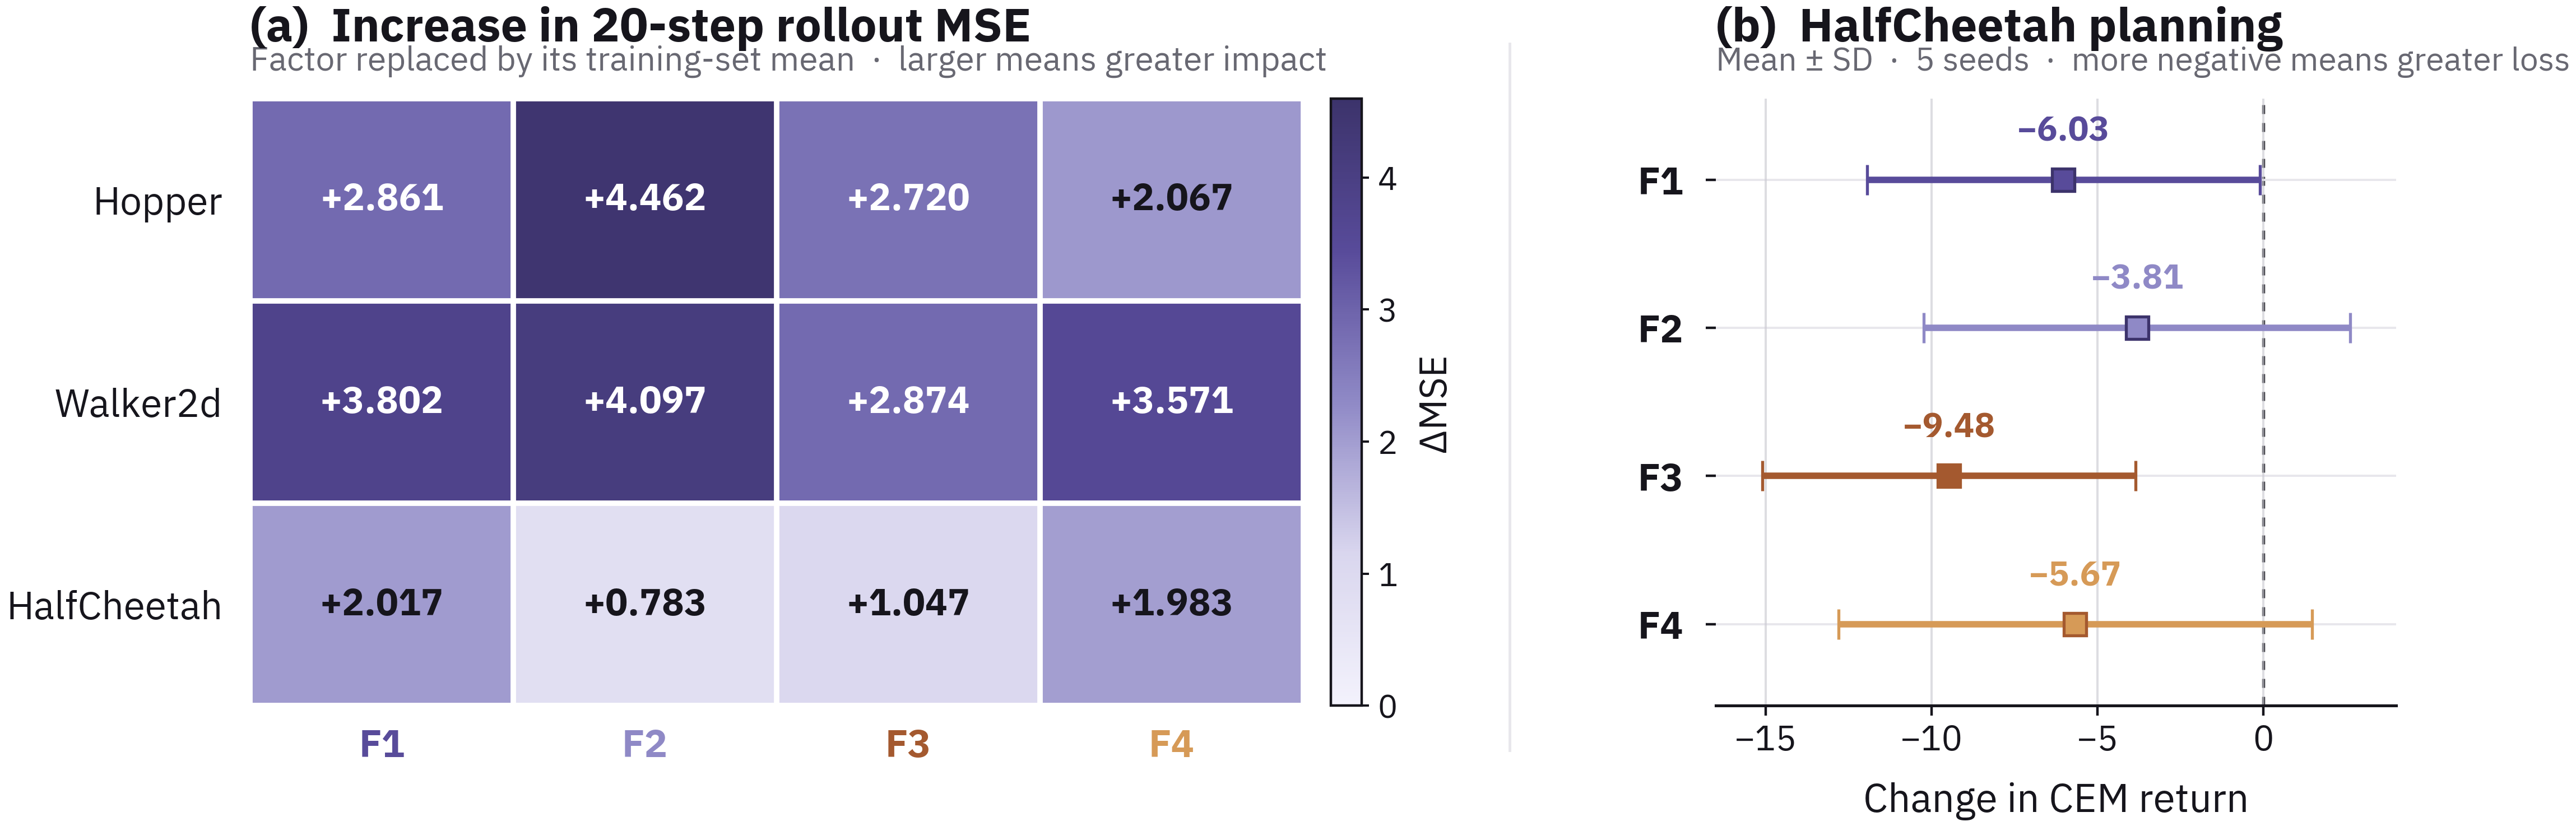
设置:对完整 K = 4 模型,32 维状态被划成四个学习到的 8 维子空间。在留出转移上,用一个独立的 ridge 探针每次只用一个因子去预测下一步观测变化 Δot = ot+1 − ot。此外还测量因子级标准差、在 20 步推演中把某个因子替换为训练集均值、以及在真实环境的配对 CEM 评测中重复同样的干预。
可读性(descriptive readout):在 Hopper 上,F1–F4 最可读的变化依次是脚部角度(R² = 0.294)、躯干高度(0.347)、躯干角度(0.424)、腿部角度(0.310)。论文明确标注:这些是线性可及的运动偏好,而不是预先指派的一对一因子标签——一个因子可能保留若干相关变量的信息。
活性:四个组全部保持活跃。因子级标准差落在:Hopper 0.692–0.715,Walker2d 0.587–0.601,HalfCheetah 0.673–0.678。
功能性:把任一因子替换为训练集均值会在三个环境中全部提高推演误差。在 HalfCheetah 上,屏蔽 F1 或 F3 在全部 5 个训练种子里降低回报,屏蔽 F2 或 F4 则在 5 个种子中的 4 个降低回报。
三项合起来构成一条 "活跃 → 可读 → 功能上被使用" 的证据链:OPF 提供的是几何上不重叠、活跃、且可单独干预的状态通道。
3.3.5 无力场的分子预测
问题:无力场(force-free)分子预测器直接预测未来的原子位置与速度,然后把自己的输出自回归地喂回去。即便一步预测很准,局部小误差也会累积。正交的"未来因子"能否改善一步精度和长程稳定性?
设置:每个分子状态包含原子位置、速度、种类和模拟盒。用 TrajCast 风格的等变预测器,在液态水、晶态 α-石英、气相扑热息痛和苯上评测。JEPA 预训练的参考条件记为 TrajCast-JEPA。JEPA-Anything 保留相同的系统数据、O(3) 等变骨干、预测区间、监督适配与推演协议,只在预训练阶段施加正交预测分解。
等变性处理(值得注意的细节):把 OPF 施加在 l = 1 扇区的 64 通道重数轴上,取 d = 64, K = 4, r = 16。因为一个 l = 1 不可约表示有三个分量,对应的展平块含 64 × 3 = 192 个标量坐标;学到的通道投影对三个分量施加相同的作用,等价于 Pk ⊗ I3,以保持等变性。这是一个容易被忽略但很关键的正确性细节——它说明 OPF 并非"随便切向量",而是要尊重对称结构。
评测:5 个独立训练的模型取均值。对每个种子,计算一步位移 MAE 与 100 步自由自回归后的中位数末位置 RMSD,再跨种子平均。后者是推演稳定性的主指标。
| 系统 | 指标 ↓ | 从零训练 | TrajCast-JEPA | JEPA-Anything |
|---|---|---|---|---|
| 水 | 一步 MAE | 0.00387 | 0.00452 | 0.00376 |
| 水 | 100 步 RMSD | 3.331 | 2.536 | 2.459 |
| 石英 | 一步 MAE | 0.01080 | 0.01043 | 0.01011 |
| 石英 | 100 步 RMSD | 2.089 | 1.912 | 1.877 |
| 扑热息痛 | 一步 MAE | 0.00901 | 0.00777 | 0.00705 |
| 扑热息痛 | 100 步 RMSD | 3.155 | 1.868 | 1.776 |
| 苯 | 一步 MAE | 2.59×10⁻⁵ | 2.10×10⁻⁵ | 2.05×10⁻⁵ |
| 苯 | 100 步 RMSD | 0.0958 | 0.0701 | 0.0645 |
四个系统的一步 MAE 与 100 步 RMSD 全部最低。这是摘要里"all four systems"的来源。注意水的一步 MAE:从零训练(0.00387)甚至优于 TrajCast-JEPA(0.00452),说明JEPA 预训练本身并非无条件有益,是有 JEPA-Anything 才把这一步找回来(0.00376)。
Group III · 学到的世界状态的科学分析
因子坐标被当作可复用的诊断接口
3.4.1 因子提名干预的湿实验验证
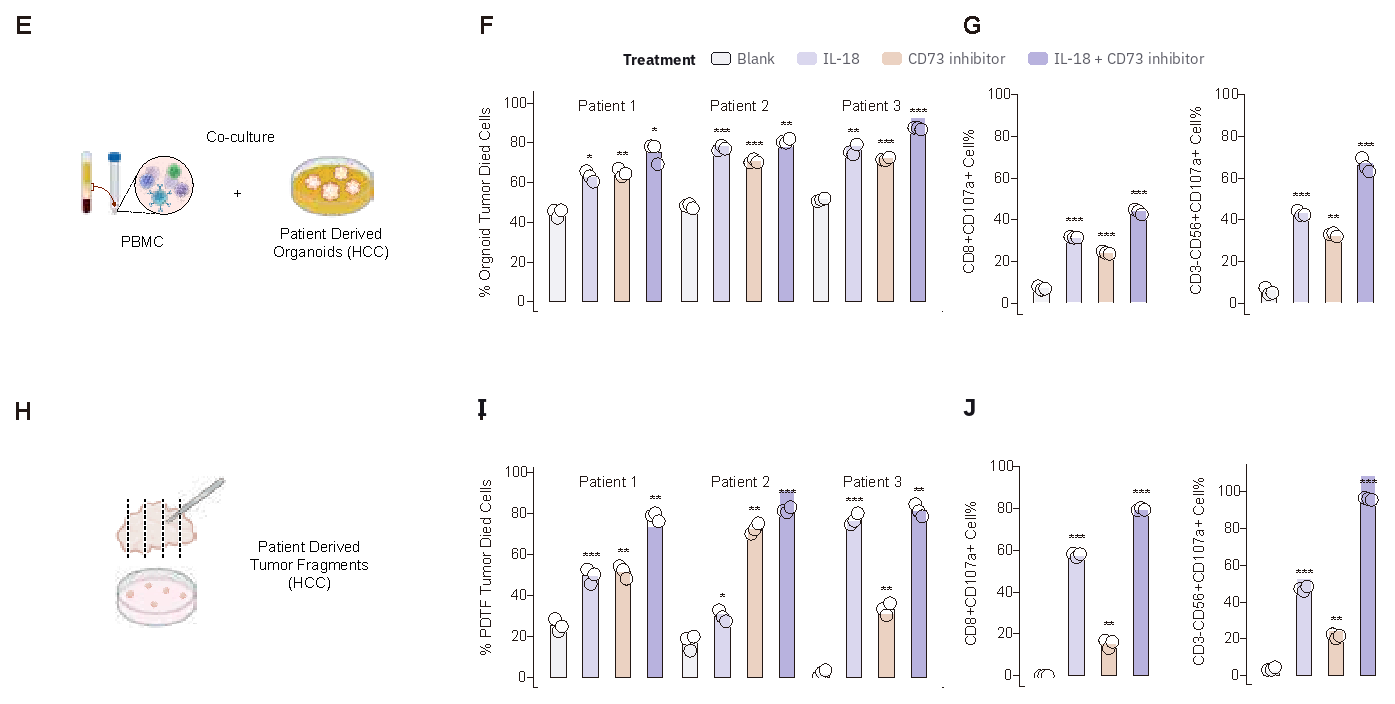
把领域特定的干预分析施加到 JEPA-Anything 学到的正交因子坐标上,结果提名了 IL-18 联合 NT5E/CD73 阻断作为一个候选干预。随后的湿实验支持了这个预测:在 Huh7–PBMC 共培养、患者来源类器官、肿瘤碎片,以及免疫健全小鼠中显示出增强的抗肿瘤活性。
3.4.2 轨道标度作为物理定律诊断
天文轨迹提供了一个互补的例子:这里不是拿隐模式去预测,而是检查隐模式里有没有可解释的定律。从无物理标签的模拟位置—速度轨迹出发,谱分析把隐频率与轨道半长轴配对。在论文的分析中,得到的模式恢复出开普勒关系 f = (2π)⁻¹ a^(−3/2),拟合斜率 −1.4991(理论值 −1.5),R² = 0.9999999。
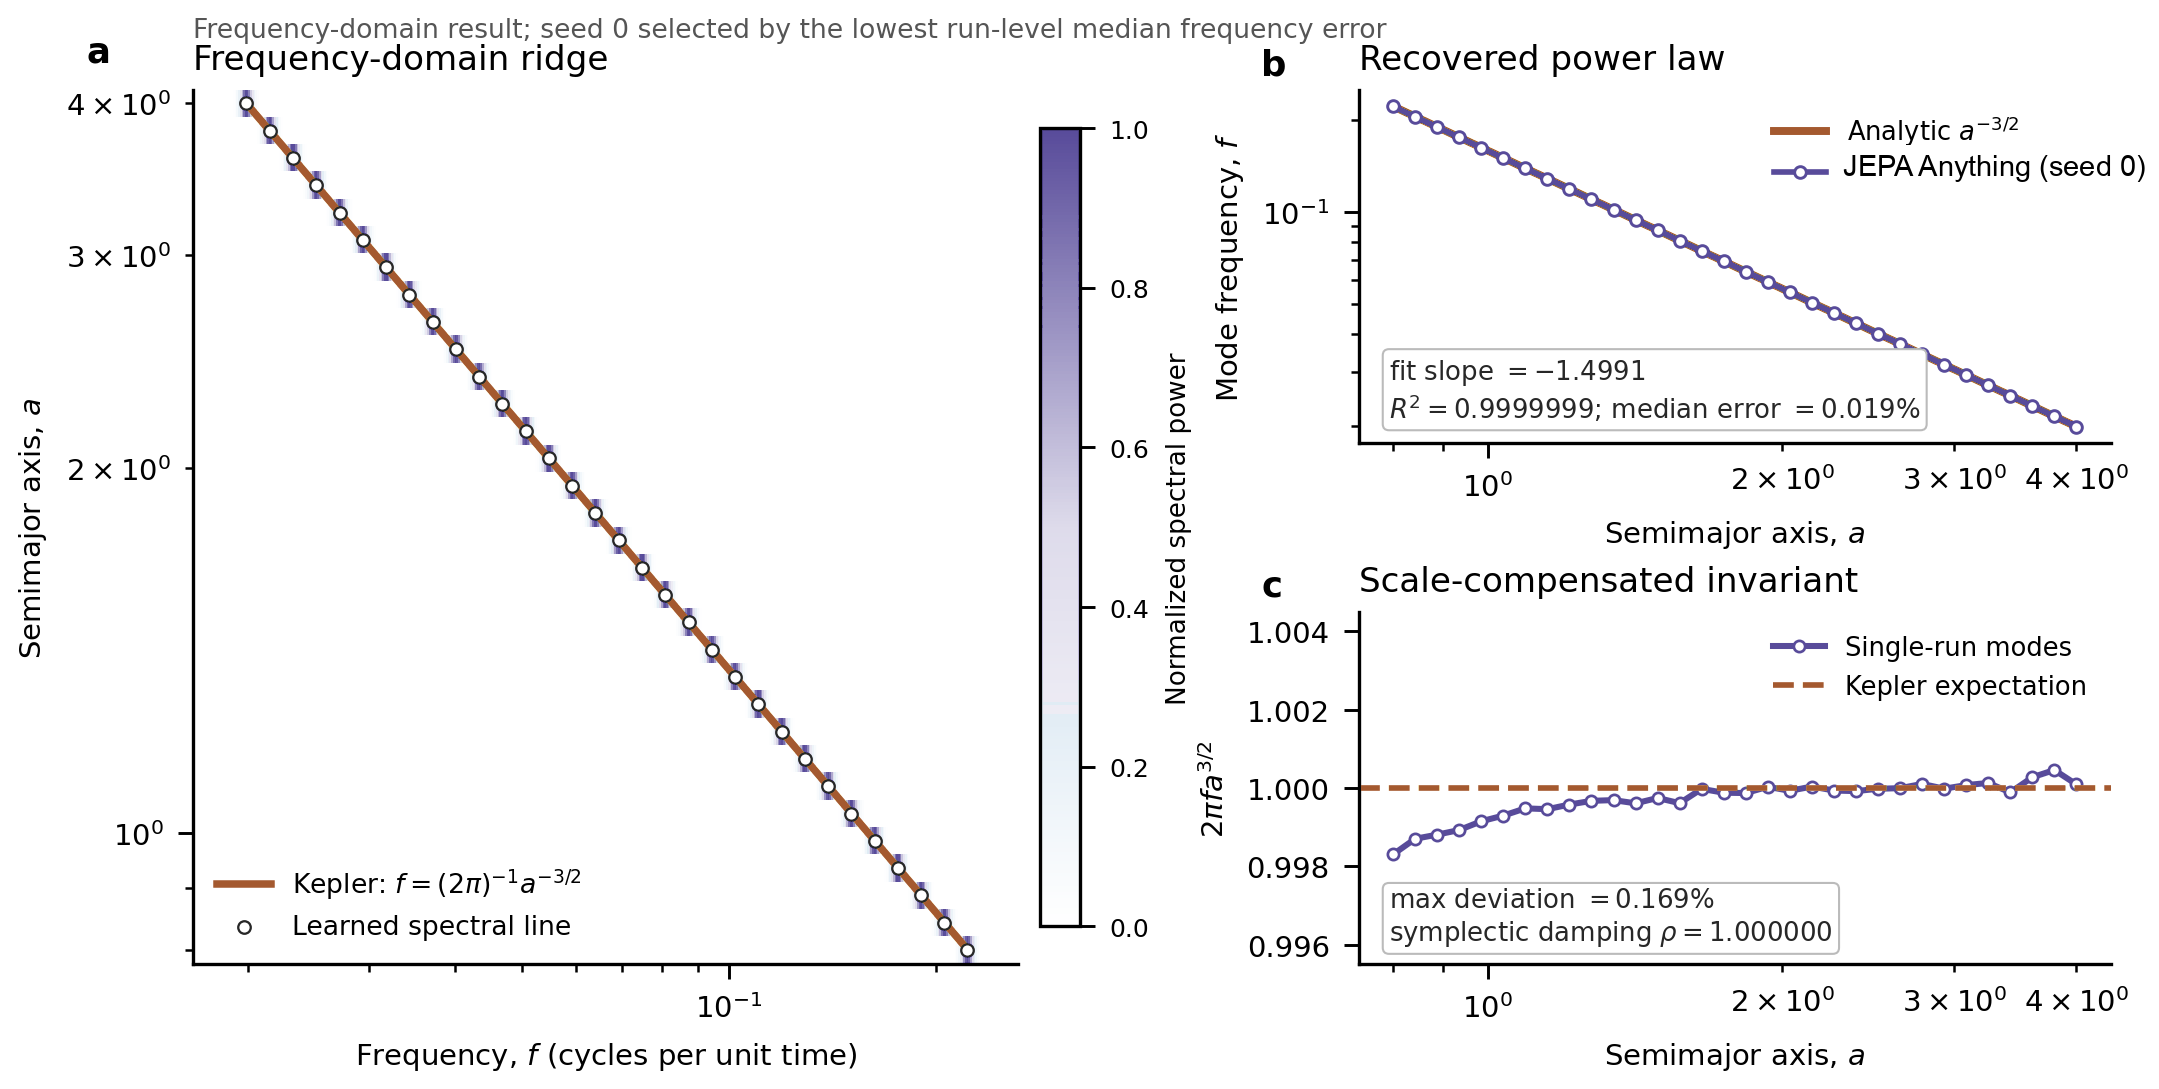
Group III 两个案例都很惊艳,但都不是统计意义上的对照实验:湿实验验证的是"提名有用",没有证明是 OPF 而非领域分析流程本身的功劳;轨道案例是单次运行(One analyzed run with analytic-law validation),没有跨种子或跨设置的重复,也没有与"不用正交因子的隐模式"做对照。R² = 0.9999999 精确到令人起疑,但因为是在合成轨迹上做谱分析,物理关系本来就很强,这个数字的意外程度远低于表观。后面第 7 节继续展开。
07 — 汇总
所有关键数字与配置,一张表看完
跨域实例化配置
| 组/领域 | 上下文 → 目标 | 骨干 / 接口 | d; K×r | 种子 / 划分 / 指标 |
|---|---|---|---|---|
| I 视觉 · 受控 MuJoCo 场景 | 可见 patch → 掩码 patch 状态 | DINOv3 ViT-S / SigLIP2 Base | 384; 4×96 768; 4×192 | 10 种子;图像不相交 + 留一单元;INJ / Coll. / Rec. |
| I 单细胞 · 肾脏 / PBMC-10K / Adamson / Norman | 表征:掩码表达 → 完整细胞状态;Norman:zresp=zobs−zctrl | scGPT | 512; 4×128 | 5 种子;肾预训练;PBMC 微调/零样本 + 跨数据集扰动迁移;AvgBIO / Pearson |
| I 临床 · 纵向多模态队列 | 患者史 → 未来患者状态 | GPT-2 small + 风险解码器 | 768; 4×192 | 5 种子;固定患者级划分;1000+ 事件风险;PRAUC |
| II 干预 · CITRIS Interventional Pong | 观测 + 干预 → 下一状态 | 匹配的编码器与预测器 | 160; 5×32 | 5 配对种子;单/组合干预一步 + 六步自由推演;四通道 MSE |
| II 动力学 · CausalWorld / DMC / PDEBench / WeatherBench2 | 状态、帧、动作或外力 → 下一状态或场 | 匹配的任务专属编码器与转移 | 128; 4×32 | 5 种子;留出/OOD + 六步推演;MSE 与回报 |
| II PDE 审计 · APEBench Burgers / KS | 当前场 → 下一场 | MLP;首层权重 256×64 | 128; 4×32 | 5 配对种子;留出晚期 + Burgers 六步推演;MSE |
| II 长推演 · 1 维粘性 Burgers,64 点 | 当前场 → 自回归未来场 | MLP;xdim=1024;隐宽 256 | 128; 4×32 | 3 种子;2000 训练步;ID/高频 OOD 的 H20/H50;MSE |
| II 运动 · Hopper / Walker2d / HalfCheetah | 状态 + 动作 → 未来控制状态 | 隐动力学 + CEM 规划器 | 32; 4×8 | 5 种子;匹配重置 + 20 步因子干预;回报 / R² / MSE |
| II 分子 · 水 / 石英 / 扑热息痛 / 苯 | 原子状态 → 未来分子状态 | TrajCast 风格 O(3) 等变;l=1 扇区 | 64; 4×16(通道) | 5 种子;100 步自由推演;MAE / RMSD |
| III 生物 · Huh7–PBMC / 类器官 / 肿瘤碎片 / 小鼠 | 因子坐标 → 候选干预提名 | OPF 因子分析接口 | 保留 Pk | 3 类器官 + 3 碎片 + 外部小鼠验证;杀伤与活化 |
| III 轨道 · 模拟位置—速度轨迹 | 因子坐标 → 隐谱模式 | 轨迹编码 + 谱分析 | 保留 Pk | 单次分析运行 + 解析定律验证;斜率与 R² |
OPF 超参数与正则系数
| 实验 | d | K | r | λorth | λfac | λenc |
|---|---|---|---|---|---|---|
| CITRIS Interventional Pong | 160 | 5 | 32 | .10 | .05 | .02 |
| CausalWorld 状态/控制 | 128 | 4 | 32 | .10 | .05 | .02 |
| DMC 像素动力学 | 128 | 4 | 32 | .10 | .05 | .02 |
| DMC-VB 留出回合 | 128 | 4 | 32 | .10 | .05 | .02 |
| PDEBench Burgers | 128 | 4 | 32 | .10 | .05 | .02 |
| PDEBench 反应—扩散 | 128 | 4 | 32 | .10 | .05 | .02 |
| PDEBench 浅水方程 | 128 | 4 | 32 | .10 | .05 | .02 |
| 合成 PDE | 128 | 4 | 32 | .10 | .05 | .02 |
| 合成像素动力学 | 128 | 4 | 32 | .10 | .05 | .02 |
| WeatherBench2 | 128 | 4 | 32 | .10 | .05 | .02 |
| APEBench Burgers / KS | 128 | 4 | 32 | .10 | .05 | .02 |
| Hopper-v5, 20 步 | 32 | 4 | 8 | .02 | .10 | .02 |
| Walker2d-v5, 20 步 | 32 | 4 | 8 | .02 | .10 | .02 |
| HalfCheetah-v5, 20 步 | 32 | 4 | 8 | .02 | .10 | .02 |
观察:绝大多数实验共用同一组超参数(d=128, K=4, r=32, λ = .10/.05/.02),只有运动控制(低维状态,故 d=32, r=8)把 λorth 调低、λfac 调高,CITRIS 用了 K=5。几乎没有逐领域调参,这本身就是"通用原理"叙事的一部分支撑。
额外实现细节(附录 B.1)
- APEBench 的 Burgers 与 Kuramoto–Sivashinsky 模型用 MLP,第一层线性权重形状 256×64,OPF 维度 d=128, K=4, r=32。
- Norman 单细胞模型用 d=512, K=4, r=128,预测目标定义为 zresponse = zobserved − zcontrol。
- 所有实验使用被引用骨干实现的默认架构与优化设置,非 OPF 的设置在每个匹配对照内保持共享。
08 — 批判性评估
哪些地方站得住,哪些地方要存疑
论文写得克制、诚实(连负面结果都照实报),但作为读者仍应区分证据强度不同的三类主张。
站得很稳
- 正交性的几何性质:Table 5 的 5 数量级差距 + 两条命题,机制自洽、可复现、可验证。
- 参数量/FLOP 匹配:控制在 0.3% / 2% 以内,排除了"偷算力"的解释。
- 可加性与通用性:几乎同一组超参数跨 7 个领域,说明它不是逐领域工程。
- 因子分布式活跃:3.782/4 有效因子 + 屏蔽实验,排除了"一块干活三块陪跑"。
要打折看
- 长程收益衰减:Burgers H20 −5.84% → H50 −3.15%;CITRIS 单干预 −34.8% → 六步 −8.6%。越难越弱。
- 控制上并非普遍更好:Hopper 上标准 JEPA 胜出,作者也承认是环境依赖。
- 视觉增益很薄:SigLIP2 上 INJ .483 → .490,Coll. .514 → .503,没有置信区间或显著性检验。
- 不同任务改进幅度差异大:PDEBench 近乎折半,DMC 像素动力学只有 0.5% 量级。
证据最弱
- 湿实验无正交因子消融:没有"不用 OPF 的因子坐标"对照,无法把功劳归给 OPF 而非领域分析流程。
- 轨道案例是单次运行:无种子重复、无对照、无分布检验;R²=0.9999999 在合成轨迹谱分析里并不意外。
- 因子身份不等于语义/因果:论文自己反复强调这一点,但读者很容易过度解读 F1–F4。
- 缺 K 的消融:正文没有报告 K ∈ {1,2,4,8} 的性能曲线(K=1 应当退化为标准 JEPA,是关键的"零假设点")。
值得追问的几个技术问题
- K 该怎么选?论文说"因子块的数量和宽度可按实例的预测复杂度配置",并给了 K ∈ {1,2,4,8} 的参数量校准数据,但没有给出 K 对性能的影响曲线。既然 K=1 恰好退化成标准 JEPA,那条曲线就是最直接的因果证据——缺了它,"因式化带来增益"的说服力就依赖跨任务一致性而非单点对照。
- 正交性与"预测容量分配"是同一个东西吗?论文的核心叙事是"分配预测容量",但实现机制是正交性 + 活性下限。两者其实可以分开:可以因式化但不正交(这正是被批评的"无约束多头"),也可以只加正交但不变容量。Table 5 只对比了前者。因此"正交性"这一项被验证得很硬,"多种因子分工"这一项更多靠路由统计(3.782/4、dominant share 0.324)间接支持。
- 因子会随训练不稳定地漂移吗?因子身份从可预测性涌现,意味着不同种子可能学到不同的因子划分。论文对每个实验都报了 5 个种子的均值,但没有报告跨种子的因子对齐度。这直接影响"因子坐标能否当可复用诊断接口"这一主张(Group III 的前提)。
- 为什么直接回归因子而不是用方向性损失?论文的理由是"保住状态合成所需的方向与幅度"。这个理由成立,但也意味着 ℒpred 对幅度的敏感度较高;在目标尺度跨域差异巨大时(比如分子 RMSD 与水的一步 MAE 相差三个数量级),是否存在尺度相关的隐式权重问题?论文未讨论。
- 等变性约束的推广。分子部分用 Pk ⊗ I3 保住 O(3) 等变,这个处理很干净。但它意味着"对不可约表示分量施加相同投影"是一个额外的方法论要求——推广到其他带对称群的领域(比如等变图网络、晶体)时需要重新推导,论文没有给出一般形式。
- 计算开销的真实账本。论文报了参数与 FLOP 差异(≤0.3% / ≤2%),但 OPF 引入了 K 个预测器头与一次 d×d 伪逆(虽然 K=d/r,通常在 10³ 量级,代价可忽略)。真正的开销可能在训练时的方差统计与正交损失,以及 K 个分支带来的显存与通信模式变化。这类工程成本未被讨论。
研究诚信相关信息(附录 B.3–B.5)
- AI 使用声明:作者明确声明使用了 OpenAI Codex 进行语言润色与翻译、LaTeX 重构、一致性/文献/数学检查、图的裁剪与排版,以及在实验设计、统计报告、结果解读与呈现上的反馈。作者审阅了所有改动,并对照原始材料核对了引用来源、推导与实验主张,科学决策由作者做出。
- 伦理声明:临床实验使用通过受控研究与数据治理流程获取的去标识化 UK Biobank 参与者数据,分析在已批准的研究申请与机构伦理/数据使用要求范围内进行,不重新分发任何个体级数据。
- 可复现性声明:第 2 节规定了可加 OPF 损失、与原实现损失的组合方式、活性统计量与合成映射;第 3 节明确了数据、匹配基线对照与指标;Table 2 记录上下文—目标构造、因子维度、评测划分与种子数;附录 Table 10 报告正则系数。
这是一篇方法极简、野心极大、证据强度不均的论文。它最硬的部分是把"多个预测头合成一个状态"这件看似工程化的事,变成了一个有命题支撑的几何问题(正交 → 单位条件数 → 无偏且稳定合成),并用 Table 5 的 5 个数量级差距把它钉死。它最软的部分是"跨世界的通用性"叙事——七个领域的成功更多证明了这个可加正则项不挑领域,而不是证明了共享表征或共享机制。至于"湿实验验证"和"开普勒定律",作为方向性演示很有冲击力,但作为科学证据仍需更强的对照与重复。
论文自己给的未来方向
作者把下一步指向"让预测模型成为主动调查世界的系统组件",并连接到 Discovery Foundation Models(把发现视为"提出问题—构造表征—提出假设—通过外部证据修正"的过程)。两个具体的衔接点是 ScienceIDE(提供可执行科学环境,让智能体跑分析、调仿真、拿可验证反馈)与 ScienceBuddy(交互式研究工作台,把 harness 演化与模型学习耦合)。
作者也点明了超出预测精度之外的三个开放问题:如何在分布漂移下校准不确定性;如何判定一个学到的模型"可靠到足以指导实验";以及当新证据揭示缺失结构时如何修订预测因子。最后一句态度很清醒:正交因子本身并不建立因果机制,共享的预测架构也不保证跨领域的表征对齐。
09 — 速查
一页带走
核心公式
| 式 | 内容 | 作用 |
|---|---|---|
| (1) | x →(𝒜δ) (H,S) →(𝒱δ) (HC,SC,T,ST) | 统一接口;适配器负责观测几何 |
| (2) | θ̄ ← mθ̄ + (1−m)θ | EMA 目标编码器,不接收梯度 |
| (3) | zt(k) = Pk⊤ sg(zt) | 把目标嵌入切进 K 个子空间 |
| (4) | ẑt(k) = qk(zc, st) | 每个因子一个专属预测器 |
| (5) | ẑt = (P⊤)† ût | 状态合成——整个框架的公共出口 |
| (6) | ût+1 = [qk(zt, ξt, st+1)]k | 操作性转移 / 隐推演的一步 |
| (7) | ℒpred = L2 回归每个预测因子 | 保住合成所需的幅度与方向 |
| (8) | ℒorth = 因子内正交归一 + 因子间正交 | 防止多个因子编码同一方向 |
| (9) | ℒfac, ℒenc = 对方差下限的合页损失 | 防因子与编码器坍缩 |
| (10) | ℒtrain = ℒbase + ℒpred + λoℒorth + λfℒfac + λeℒenc | 可加——能挂到任何已有 JEPA 实现上 |
| (11) | ‖P⊤z‖² = Σ‖Pk⊤z‖² = ‖z‖² | Prop 1:不丢信息(正交直和) |
| (12) | ‖ẑ−z‖ = ‖e‖, κ₂(P) = 1 | Cor 1:正交下合成无损且稳定 |
| (13) | √(1−ε) ≤ σi(P) ≤ √(1+ε) | Prop 2:近似的奇异值夹逼 |
| (14) | ‖ẑ−z‖ ≤ ‖e‖/√(1−ε) | 正交性残差控制误差放大倍率 |
术语对照
| 术语 | 含义 |
|---|---|
| OPF(Orthogonal Predictive Factorization) | 正交预测分解。把隐目标拆成 K 个正交子空间、各配专属预测器、再合成回完整状态的机制。 |
| Latent world-state interface | 隐世界状态接口。x → 适配器 → 视图采样器 → 上下文/目标 这一条所有领域共用的管道。 |
| Adapter / View sampler | 适配器 𝒜δ 定义观测几何;视图采样器 𝒱δ 定义上下文—目标语义。两者是领域相关的唯一边界。 |
| Monolithic JEPA | 整体式 JEPA。用一个整体目标嵌入 + 一条预测路径的标准 JEPA,是全文的主要对照。 |
| Factor activity | 因子活性。用合页损失维持每个投影坐标在样本间的标准差,防止因子塌成常数。 |
| Operational world-model mode | 操作性世界模型模式。保留投影器与预测器,把合成隐状态当作转移算子用于规划/推演。 |
| Representation mode | 表征模式。丢掉投影器与预测头,只用在线编码器特征接下游读出。 |
| Condition number κ₂(P) | 条件数。正交时 = 1;退化时无界,直接决定因子预测误差被放大的倍率。 |
| DFM(Discovery Foundation Model) | 未来工作里引用的概念:把发现形式化为"提问题—建表征—提假设—靠外部证据修正"的循环。 |
如果你想自己跑
- 代码:github.com/Gen-Verse/JEPA-Anything;模型:HuggingFace Gen-Verse/jepa-anything 合集。
- 最小改动路径:找到你现有 JEPA 实现里的预测损失,在旁边加上 ℒOPF;把单一投影头换成 K 个共享主干 + 分叉头;加一次 d×d 伪逆做合成。
- 起步超参可直接照抄主表:d=128, K=4, r=32, λorth=.10, λfac=.05, λenc=.02。
- 验证是否真的起作用:先查 κ₂(P) 是否接近 1(Table 5 的审计指标),再查有效因子数是否接近 K(论文报告 3.782/4)。这两项比重上的指标更能说明机制是否真的在生效。