Velocity Scaling · 论文精读速度缩放真正修的是什么
Velocity Scaling in Flow Matching
Youssef Saied(日内瓦大学)· François Fleuret(日内瓦大学 & Meta FAIR)
一句话:有人在采样时把流匹配的速度场乘一个增益 γ,效果很好(FID 13.7 → 7.6)。原论文说这是"修 MSE 训练导致的速度低估"。这篇论文证明:不是。 真正的原因是群体时间滞后(population time lag)——采样到模型时间 t 的状态,看起来像训练路径上更早的状态。速度缩放和"把模型时间往回拨"是解决同一个问题的两条路。
01 — 30 秒速览
这篇论文做了什么
它是一篇"纠错 + 重新解释"型的论文。前人发现了一个有效但解释不清的技巧,本文拆掉了错误的解释,给出了新的机制,并把新机制变成了一套不需要图片指标的增益标定方法。
① 推翻旧的解释
原论文(Li 等,2026b)称 MSE 训练让速度场系统性低估速度幅度,缩放是在"补上缺失的幅度"。
本文证明:MSE 的最优解恰恰是精确传输场。Jensen 不等式给出的"幅度缺口"其实是条件目标方差(合法的多轨迹穿越),不是丢失的速度。实测最优标量乘子均值 0.999,处处接近 1。
② 给出新机制
提出并测量 群体时间滞后:在粗采样下,t 时刻的生成状态在训练路径上"读起来"更早。
用一个学到的探针 ŝφ(x,y) 从状态估计路径时间。滞后 δ̂φ(t) 是生成态与真实态探针读数之差。NFE 越低滞后越大。
③ 两条等价路线
时间校正:把喂给网络的 t 换成 t − δ̂φ(t),不改积分时钟、不乘速度。
速度缩放:把状态沿当前速度方向多推一点。一阶近似下 γ(τ−t) ≈ h,让状态追上它的时间标签。
④ 无图片指标的标定
直接最小化测得的滞后来选 γlag——不用解码、不用 FID。NFE 25 时能恢复 81% 的 FID 改善。
成本:gain 分辨率 0.01、每个候选 256 条轨迹,共约 1,536 条轨迹 / 76,800 次模型评估。
⑤ 滞后只解释一部分
FID 最优增益总是高于滞后增益,即使积分变精细、滞后已很小。多出来的部分大致是每个模型一个常数倍率 κ(在 NFE 25 拟合、推广到 50/100/250)。
⑥ 增益不是模型的固有属性
最优增益随求解器精度、引导强度、评价指标变化。CFG 增强时最优增益会降到 1 以下(引导 2.25 时 0.95)。CIFAR-10 的 decoder-free 模型几乎无滞后,最优增益恒为 1。
它示范了一种很干净的研究范式:把一个"有效但解释错误"的启发式技巧当靶子,先用理论+测量推翻旧解释(§4),再提出可测量的新机制(§5),然后用控制实验排除替代解释(§6),最后把机制变成可操作的标定流程(§5.4 / §7)。而且它非常诚实地标出了自己解释不了的部分(§7.2 的 κ、§H.1 的指标权衡)。
02 — 背景
速度缩放是什么,前人怎么解释的
2.1 流匹配的设定
对 t ∈ [0,1],设 X₀ 是源噪声、X₁ 是数据、U = X₁ − X₀。线性训练路径从噪声走到数据:
流匹配损失的群体最优解(population minimizer)是条件期望:
论文严格区分这个群体场 v* 与采样时用的学习场 vθ。这个区分是全文的支点。
2.2 速度缩放
采样时,把模型的速度预测乘一个标量增益(只在速度进入采样器的地方乘,不乘状态、不乘随机噪声项):
γ(t) = 1 就是不缩放。常数增益指 γ(t) = c。前人(SSC)用的是 γ(t) = 1.1 − 0.1t。
前人自己的消融显示:常数增益 1.05 得到 FID 7.8,SSC 的时变 schedule 得到 7.6,而多个均值相近的不同 schedule 得到 7.5–7.8。也就是说schedule 形状对 FID 影响很小。因此本文默认用常数增益——这大幅简化了后续所有分析。
2.3 前人的解释:速度低估假说
Li 等(2026b)的论证是:当目标速度 U 在给定 Xt 时方差非零,Jensen 不等式意味着条件均值的范数平方小于目标本身的范数平方:
他们把这个差解释为"MSE 训练丢掉的幅度",因此认为乘个大于 1 的增益是在补回来。这个解释听起来合理、也有公式支撑——但本文指出它把"条件目标方差"误读成了"缺失的速度"。
03 — 第一步:推翻旧解释
MSE 训练没有制造速度缺口
3.1 群体场是精确的
论文用标准的方差恒等式指出那个"缺口"到底是什么:
第二项度量的是条件目标方差——它反映的是多条合法训练轨迹在状态 Xt 处交叉穿越,而不是缺失的速度。而条件均值 v* 仍然是精确把源分布输运到数据分布的群体速度场。
Jensen 不等式给的"幅度差"是定义上必然存在的(只要条件方差非零),它任何情况下都存在,与"训练好不好"无关。把它当成缺陷,等于把"目标本身有方差"误诊为"模型学漏了"。
论文给了一个具体的高斯例子:条件目标方差为正,但增益 1 就给出精确传输,而任何其他增益都会改变端点协方差(附录 B.2)。
3.2 训练出来的场也不是系统性欠缩放
群体解精确,不代表有限训练不会欠缩放。论文在 20 个 t 取值上,用 16,000 对 ImageNet 图像–噪声,拟合最小化留出流匹配误差的标量乘子:
论文论证这个量同时也是"让 γ̂FM(t)·vθ 在真实训练路径状态上最贴近群体场"的最小二乘标量。结果是:
拟合结果
均值 = 0.999
拟合曲线在每个时间点都贴近 1(论文附录 Figure 7)。因此这个预训练 SiT 模型在真实训练路径状态上并不系统性欠缩放。
于是问题变成
既然群体场精确、学习场也没欠缩放,那缩放为什么能改善生成质量?
论文给出的唯一可能方向:采样到的状态与真实训练路径状态不同,而速度缩放缩小了这个错配。这就把论文引向下一节。
04 — 核心机制
群体时间滞后(Population Time Lag)
这是全文的核心概念:在粗采样下,模型时间 t 时刻的生成状态,读起来像一个更早时间 τ < t 的真实训练状态。换句话说,状态"落在时间的后面"。
4.1 如何测量
设 y 是类别标签。在模型时间 t,令 pt(x,y) 是真实路径状态与标签的联合分布,qtu(x,y) 是无缩放采样下的对应分布。论文训练一个探针 ŝφ(x,y),从状态和标签估计路径时间。群体时间滞后定义为:
为什么要减掉真实状态的基线?因为要确保"探针自身的固有偏置"不被算成采样滞后(附录 D.2)。正值意味着生成状态比当前求解器时间像更早的路径点。论文把减小这个滞后称为 catch-up(追赶)。
研究者必须证明探针测的是"沿路径的时间",而不是"状态变了就随便报个数"。他们做了方向控制实验:
- 把每个留出的真实状态替换为同一条路径上早 0.05 时间单位的状态 → 探针平均估计时间下降 0.0499(几乎完全命中已知的时间变化)。
- 把原状态沿垂直于路径的方向移动相同距离 → 平均估计时间只下降 0.00519。
结论:探针精确追踪沿路径的时间变化,而对垂直位移的响应小一个数量级。这个 0.0499 vs 0.00519 的对比,是全文方法论上最扎实的一环。
4.2 为什么会滞后:粗积分的直观解释
论文给了一个极端的例子:只用 2 步 Euler(NFE 2)。设 x(t) 沿精确群体场 v* 从噪声 x₀ 出发,μy 是类均值。第一步把到 t=0.5 的积分替换为单次速度评估:
丢掉的是中途的速度更新,也就是图像结构的逐步细化(refinement)。把 Euler 状态与 t=0.5 的真实状态相比,探针会给 Euler 状态分配更早的时间——缺失的细化被读成了滞后。
一个精巧的细节:为了聚焦"图像结构"而非全局尺度,这个比较中探针接收的是归一化后的状态。这样"整体范数"就不能被当作时间线索,滞后仍然存在——说明滞后不只是尺度问题。
4.3 两条修正路线
路线 A · 模型时间校正(Model-Time Correction)
把喂给网络的 t 替换为 t − δ̂φ(t)。不改积分时钟、不乘速度。
效果(NFE 50):SiT 上 FID 13.8 → 8.8;ADM U-Net 上 22.7 → 16.7。
对 ADM,常数增益 1.075 能到 13.2,所以测得的时间错配对图像质量的影响可以跨架构迁移,但不足以解释缩放的完整收益。
路线 B · 速度缩放
不改编时钟,而是让状态沿当前速度方向多推一段,使它在下次模型调用时更好地匹配新的时间输入。
一阶论证:从 xt 走一步长 h,若更新后的状态其实像更早的真实状态 xτ(τ < t+h):
则在路径的局部一阶近似下,缩放速度给出
即:缩放把滞后的状态推进到与它下一次时间输入相符的位置。
4.4 从滞后到增益:γlag
论文用最小化沿采样轨迹的平均平方滞后来选常数增益:
每个增益在同一批 1,280 条轨迹上评估(固定初始状态、类别标签、布朗路径),用 Brent 标量最小化配合括号搜索。这个目标函数既不解码图像、也不用任何图像质量指标。
05 — 交互
亲手调一次:滞后、增益与"多出来的那部分"
下面这个交互复现论文的核心定量关系。拖动NFE(函数评估次数)和增益 γ,看两件事: ① 无缩放采样时滞后随 NFE 下降而增大;② γlag(最小化滞后)只追回一部分 FID 改善, 剩下的要靠乘一个倍率 κ——这正是论文 §7.2 "滞后只解释一部分"的结论。
读数以论文的 SiT-XL/2 无引导 ImageNet-256 实测值为锚点(Table 8 / Table 10),曲线形状按论文描述的定性趋势插值重建。
这是一个定量示意:锚点(无缩放 FID、最低 FID、γlag、γ*FID、滞后 RMS)取自论文实测表格,但中间的连续曲线是按论文趋势插值重建的,不是论文原始数据点。真实数字请以下方表格为准。
06 — 证据链
控制实验:排除竞争解释
论文第 6 节用一组控制实验,逐一排除"缩放的收益到底来自哪里"的替代解释。这是它论证最有力的部分。
6.1 变化状态响应(Changed-State Response)
考虑两条确定性 Euler 轨迹,相同初始状态与时间网格:无缩放轨迹 xk、缩放轨迹 yk。令 Δk = yk − xk,则
第一项是直接额外推力(平行于无缩放速度),第二项是变化状态响应——来自"在移动后的状态上重新评估模型"。控制实验就是分别保留/去掉这两项。
冻结场控制(Frozen-field Control)
从相同初始状态出发,沿着无缩放轨迹上记录的速度预测乘以增益——模型从不评估移动后的状态,因此完全排除变化状态响应。
结果(5 个 SiT checkpoint,随机采样下):只达到完整速度缩放 FID 改善的 22.4%–24.9%。
→ 随机采样下,大部分收益需要模型在移动后的状态上重新预测速度。但在确定性采样下这个控制能达到 53.9%(SiT)/ 59.0%(ADM U-Net),说明 ODE 与 SDE 下机制权重不同。
径向控制(Radial Control)
把额外速度 (γ−1)v 替换为 (γ−1)·‖v‖·x/‖x‖(同样在移动后的状态上评估模型,推力范数相同但方向变成径向)。
结果:径向控制让 FID 变差,而速度缩放让它变好。
→ 具体数字(NFE 50、gain 1.05、SiT-XL/2、50,000 张图):速度缩放 FID 13.9 → 7.8;径向控制反而升到 19.4。所以"额外推力的方向"本身就很重要,不是"多推一点就好"。
- 不是场的统一欠缩放(§4 + 附录 F.1:最优乘子 = 0.999)。
- 不是简单的 Euler 端点误差修正(附录 F.2:细化积分会大幅降低无缩放端点误差,但 SSC 端点仍然远离精细无缩放参考;SSC 还增大了 ODE 与 SDE 的一步误差)。
- 不是端点矩匹配(附录 F.4:采样后再匹配半径/方向方差对 FID 几乎无影响;匹配完整隐均值+协方差反而变差)。
6.2 变化状态响应的方向比范数更重要
把响应 rk = vθ(yk,tk) − vθ(xk,tk) 分解为平行/垂直于无缩放速度的分量。在 SiT-XL/2、NFE 50 公开 hybrid SDE、gain 1.05 下:
| 干预 | FID ↓ | 说明 |
|---|---|---|
| 只保留垂直分量 | 8.4 | 接近完整缩放 |
| 完整速度缩放 | 7.7 | 最好 |
| 只保留平行分量 | 12.1 | 远差于完整缩放 |
由于两个分量的范数不同,论文又做了等范数方向控制(把垂直响应替换为同范数的正向/置乱向量),结论仍然是:实现的垂直响应在 FID 与 DINOv2 特征距离上都优于每个等范数方向控制,且这个 FID 排序在 NFE 25 和 250 上同样成立。方向确实携带超出范数的信息。
6.3 求解器精度的影响
同样 50 次模型评估预算下,把 Euler 换成 stochastic Heun:
| 指标 | Euler(50 步) | Heun(25 步预测–校正) |
|---|---|---|
| 强端点误差 | 0.208 | 0.148 |
| 群体滞后 RMS | 0.019 | 0.005 |
| 最低 FID 增益 | 1.10 | 1.05 |
更好的积分同时降低滞后和最优增益——这与 catch-up 解释一致。但论文同时强调:SSC 不是简单的积分误差修正(它反而增大一步误差),所以缩放在改变采样路径,而不只是补偿数值误差。
07 — 数据
关键表格
7.1 主结果:无缩放 vs 滞后增益 vs 最低 FID
这是全文最能说明"滞后只解释一部分"的表。三个 FID 列分别是:完全不缩放、用滞后选出的增益、以及增益网格上实测的最低 FID。
| 模型 | NFE | 无缩放 FID | 滞后增益 FID | κ 调整后 FID | 实测最低 FID |
|---|---|---|---|---|---|
| SiT-S/2 | 25 | 71.1 | 50.9 | 44.4 | 44.4 |
| 250 | 50.6 | 49.9 | 44.1 | 43.8 | |
| SiT-B/2 | 25 | 47.9 | 30.2 | 25.9 | 25.9 |
| 250 | 29.1 | 28.5 | 24.8 | 24.8 | |
| SiT-L/2 | 25 | 30.2 | 16.1 | 13.4 | 13.4 |
| 250 | 14.6 | 14.4 | 12.2 | 12.2 | |
| SiT-XL/2 | 25 | 28.0 | 12.2 | 8.7 | 8.7 |
| 250 | 9.7 | 9.1 | 6.6 | 6.3 | |
| ADM U-Net | 25 | 34.8 | 17.9 | 14.7 | 14.7 |
| 250 | 16.8 | 15.8 | 12.8 | 12.8 | |
| CIFAR NCSN++ | 25 | 3.5 | 4.5 | — | 3.5 (γ=1) |
| 250 | 2.9 | 3.0 | — | 2.9 (γ=1) |
- 滞后增益确实有效:SiT-XL/2 NFE 25 从 28.0 降到 12.2,而且这个增益完全没用到 FID。
- 但还不够:乘上 κ 后能到 8.7。三列单调下降说明"滞后"和"额外收益"是两个不同的量。
- CIFAR-10 是反例也是证据:滞后增益(1.018 等)反而让 FID 从 3.5 变差到 4.5,而最低 FID 始终在 γ=1。这与 catch-up 解释完全一致——该模型几乎没有滞后,所以缩放无从"追赶",只会引入偏差。
7.2 滞后增益与最低 FID 增益
| 模型 | NFE | γlag [95%] | γ*FID | 无缩放滞后 RMS | 滞后增益后 RMS |
|---|---|---|---|---|---|
| SiT-S/2 | 25 | 1.074 [1.070, 1.077] | 1.150 | 25.8 | 6.0 |
| 50 | 1.033 [1.029, 1.034] | 1.100 | 12.1 | 3.7 | |
| 100 | 1.014 [1.010, 1.017] | 1.075 | 5.4 | 2.4 | |
| 250 | 1.004 [1.000, 1.007] | 1.050 | 2.7 | 2.3 | |
| SiT-XL/2 | 25 | 1.077 [1.073, 1.080] | 1.150 | 25.4 | 5.8 |
| 50 | 1.034 [1.033, 1.038] | 1.100 | 12.1 | 3.9 | |
| 100 | 1.017 [1.012, 1.017] | 1.075 | 6.1 | 2.6 | |
| 250 | 1.007 [1.005, 1.010] | 1.050 | 3.7 | 2.9 | |
| ADM U-Net | 25 | 1.077 [1.075, 1.079] | 1.125 | 25.3 | 6.3 |
| 50 | 1.036 [1.031, 1.037] | 1.075 | 12.5 | 4.4 | |
| 100 | 1.016 [1.014, 1.017] | 1.075 | 6.6 | 3.6 | |
| 250 | 1.008 [1.007, 1.009] | 1.050 | 4.0 | 3.0 | |
| CIFAR NCSN++ | 25 | 1.018 [1.017, 1.019] | 1.000 | 6.0 | 3.1 |
| 50 | 1.007 [1.006, 1.008] | 1.000 | 3.0 | 2.2 | |
| 100 | 1.002 [1.000, 1.004] | 1.000 | 1.8 | 1.8 | |
| 250 | 0.999 [0.998, 1.000] | 1.000 | 1.5 | 1.5 |
两个规律很清楚:① 所有 ImageNet 模型的 γlag 随 NFE 增大趋近 1;② γlag 始终低于 γ*FID,即"消掉滞后"与"FID 最优"不是一回事。
7.3 滞后增益能恢复多少 FID 改善
| 模型 | NFE 25 | NFE 50 | NFE 100 | NFE 250 |
|---|---|---|---|---|
| SiT-S/2 | 76% | 55% | 32% | 11% |
| SiT-B/2 | 81% | 62% | 36% | 13% |
| SiT-L/2 | 84% | 66% | 36% | 9% |
| SiT-XL/2 | 82% | 63% | 42% | 19% |
| ADM U-Net | 84% | 67% | 43% | 24% |
| 平均 | 81% | 63% | 38% | 15% |
这是全文最重要的定量趋势:滞后解释力随采样变精细而急剧衰减(81% → 15%)。论文另外指出,若把二十个 ImageNet 设置等权重平均,滞后增益能恢复约 49% 的 FID 改善(从增益 1 到最低 FID 增益)——即"平均而言,滞后解释了大约一半"。这也再次说明 "速度缩放主要是一个粗采样现象",与 §7.1 的观察一致(更精确的积分需要更少的增益)。
7.4 κ 规则:一个倍率跨 NFE
论文在 NFE 25 处为每个模型拟合 κ = γ*FID(25)/γlag(25),再复用到更高 NFE。预测增益与实测最低 FID 增益的误差很小:
| 模型 | NFE | 预测增益 | 实测 γ*FID | 带符号误差 |
|---|---|---|---|---|
| SiT-S/2 | 50 | 1.107 | 1.100 | +0.007 |
| 100 | 1.086 | 1.075 | +0.011 | |
| 250 | 1.076 | 1.050 | +0.026 | |
| SiT-B/2 | 50 | 1.082 | 1.075 | +0.007 |
| 100 | 1.062 | 1.050 | +0.012 | |
| 250 | 1.053 | 1.050 | +0.003 | |
| SiT-L/2 | 50 | 1.082 | 1.075 | +0.007 |
| 100 | 1.062 | 1.050 | +0.012 | |
| 250 | 1.052 | 1.050 | +0.002 | |
| SiT-XL/2 | 50 | 1.105 | 1.100 | +0.005 |
| 100 | 1.086 | 1.075 | +0.011 | |
| 250 | 1.075 | 1.050 | +0.025 | |
| ADM U-Net | 50 | 1.082 | 1.075 | +0.007 |
| 100 | 1.061 | 1.075 | −0.014 | |
| 250 | 1.052 | 1.050 | +0.002 |
误差全部偏正(预测增益略高于实测最低 FID 增益),除 ADM NFE 100 一处为 −0.014。论文也明确提醒:这个分解"描述了观测到的增益,但并不建立两个独立的因果机制,也不给出更精细积分下的极限倍率"。
7.5 增益随设置变化
随求解器精度
NFE 增大、或用 Heun 替代 Euler → 滞后与最优增益都下降。
SiT-XL/2 固定 NFE 下,Heun 把最低 FID 增益从 1.10 降到 1.05。
随引导强度(CFG)
引导增强 → 最低 FID 增益下降并穿过 1。
引导 1.75 → 2.25 时,γlag 只从 1.027 降到 1.021,而 γ*FID 从 1.000 降到 0.950。论文证明速度幅度的变化(每单位引导 +2.6%~3.0%)远不足以解释这个下降。
随评价指标
同一采样器下不同指标偏好不同增益。
SiT-XL/2 NFE 25 时,FID 偏好的增益高于 sFID;更高的增益同时提高 precision、降低 recall。增益制造权衡,而非全面提升。
7.6 标定的稳定性与成本
| 维度 | 结果 |
|---|---|
| 轨迹数敏感性 | 128 条 → 平均增益变化 3.30×10⁻³;256 条 → 2.23×10⁻³;512 → 1.37×10⁻³;1024 → 0.55×10⁻³ |
| 探针种子稳定性 | 三个 SiT-XL/2 探针在 NFE 50、分辨率 0.01 下都选出增益 1.04 |
| 标定成本 | NFE 50 下:6 个候选增益 × 256 条配对轨迹 = 1,536 条轨迹 / 76,800 次模型评估 |
| 对比成本 | 一次 50,000 张图的 NFE-50 设置 = 250 万次模型评估、中位数 4.7 GPU 小时(RTX 4090) |
| schedule vs 常数 | 同均值增益下(1.07216,NFE 25、50,000 配对图):拟合 schedule FID 13.0,常数 12.5。常数更好(差 +0.5 [+0.4,+0.6]) |
7.7 增益不只是滞后修正:端点协方差锐化
论文用 256 个交叉拟合的真实数据方向,测幂律斜率 b:
相对幂斜率 R = b1.05/b1,R > 1 意味着缩放把相对更多的端点方差推向真实数据方差更大的方向——即"锐化"端点协方差谱。实测 SiT 的相对幂斜率在每个测试 NFE 上约为 1.06。
论文进一步用这个锐化来预测 κ:在每个更高 NFE 上找"给出相同相对锐化"的增益 γsharp(N),其倍数 κsharp 与 NFE 25 的 κ 很接近,估计 FID 在 NFE 50/100/250 上都在最低实测值 0.2 以内。
但论文也做了否证:若缩放是对整个端点密度施加单一幂变换(p1.05 ∝ p1β),留出响应方差应该被解释掉;实测残差方差比 1.14 [0.90, 1.92]——几乎没有解释任何响应方差(匹配的高斯对照把已知系数恢复到 0.01% 以内)。所以"一个密度幂系数"的解释被明确拒绝。
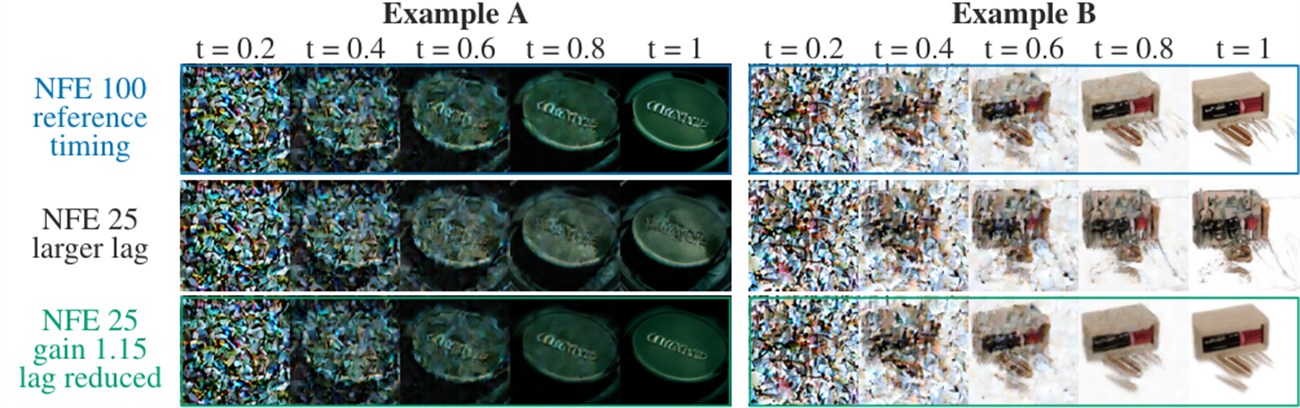
第一行(蓝框):NFE 100 参考时序。 第二行:NFE 25,滞后更大——可以看到物体发展明显更晚(t=0.4 时还很模糊,到 t=0.6 才开始成形)。第三行(绿框):NFE 25 + gain 1.15,滞后被降低——物体发育时间更接近 NFE 100 的参考。
这张图是全文最直观的证据:速度缩放让物体在粗采样轨迹上"发育得更早",更接近细采样下的时序。
模型与实验设置(论文附录 C)
| 项目 | 内容 |
|---|---|
| 测试模型 | SiT(S/2、B/2、L/2、XL/2)、REPA-SiT、ADM U-Net、decoder-free NCSN++(CIFAR-10)、official 1-Rectified Flow |
| 数据集 | ImageNet-256(4×32×32 隐空间,解码为 3×256×256)、CIFAR-10(3×32×32 像素) |
| 采样器 | Hybrid SDE、Uniform stochastic Euler、Deterministic Euler ODE、Euler–Maruyama with Mean、Velocity-derived SDE、Stochastic Heun、Adaptive RK45 |
| 评价指标 | FID、sFID、Inception Score、Precision/Recall、Density/Coverage、DINOv2 Fréchet distance |
| 探针数据 | ImageNet:12,800 训练 / 3,200 标定 / 16,000 留出(隐空间状态) |
| 不确定性 | 配对图像区间与配对轨迹区间;2,000 次公共行影响重采样;区间仅覆盖训练好的探针与真实状态基线,不含重新训练探针或候选间优化的不确定性 |
08 — 可用性分析
这篇对你的研究有什么帮助
先说清楚:这同样不是医学影像论文(全文 medical、MRI、brain、voxel、clinical 出现次数均为 0,实验只有 ImageNet、CIFAR-10)。但它比上一篇更可能直接用上——因为它讲的是采样期的东西,而采样预算正是 3D 医学影像生成的痛点。
✓ 高度相关
- 零训练改动:增益只在采样时乘上去。任何已训练好的流匹配/diffusion 模型都能立刻试,不需要重训。
- 低 NFE 场景收益最大:滞后解释力在 NFE 25 时是 81%,NFE 250 时只剩 15%。而 3D 医学影像由于显存与时间限制,恰恰被迫用低 NFE——这正是收益最大的区间。
- 标定不用图片指标:只需一个从状态估计时间的探针,而探针训练用真实路径状态(不需要生成样本、不需要 FID 评估)。对 3D 数据,这比"跑 50,000 个样本算 FID"便宜得多。
- 给出了交叉验证的工具:如果你的生成器也有"物体发育滞后"(医学里可能表现为结构边界/病灶在中间步骤还没成型),这个探针方法可以直接用来诊断。
△ 需要注意
- 全部实验是无引导或图像 CFG。而医学生成常用引导,且论文实测:引导增强时最优增益会掉到 1 以下(引导 2.25 → 0.95)。也就是说你不能再假设"乘个大于 1 的增益"。必须先在你自己的引导强度下重新标定。
- 增益不是普适常数:它随求解器、引导、评价指标变化。论文明确说"每个模型一个 κ"只是描述性的,不构成因果机制。
- 指标权衡真实存在:更高增益提高 precision 但降低 recall(§H.1)。对医学影像,"多样性 vs 保真度"的取舍可能需要与诊断性能挂钩,而不是只看 FID 类指标。
- 探针需要类别标签 y。若你的条件是连续变量(年龄、病程)或文本,探针设计要重新考虑。
✗ 没有覆盖 / 可能不成立
- 完全没有 3D / 体数据实验。所有模型是 2D 图像(像素或 4×32×32 隐空间)。3D 的"路径"语义、状态范数与滞后结构都可能不同。
- decoder-free CIFAR-10 的失败案例值得警惕:那个模型滞后很小,增益 > 1 反而有害。如果你的 3D 生成器在某些设置下滞后本来就小(比如用高阶求解器、或 NFE 较高),盲加增益会伤害质量。
- 没有医学相关的评价。FID 类指标与临床可用性之间的关系,论文无法回答。
- 滞后只解释一部分收益(最高 81%,高 NFE 只剩 15%)。剩下那部分(κ、协方差锐化)论文自己也说"不建立因果机制"。
- 先做一个最便宜的诊断:拿你现有的 3D 生成器,训练一个探针(输入状态→估计时间),测量无缩放采样下的群体滞后随 NFE 的变化。如果滞后很小,这条路直接结束——这是论文教给你的第一个判断标准。
- 如果滞后显著:先用模型时间校正(t → t − δ̂(t))试。它比速度缩放更"干净"(不改编积分),且论文显示它在随机采样下能跨架构迁移(SiT → ADM U-Net)。用它确认"时间错配"确实是问题。
- 然后扫增益:不要用论文的 1.15 直接套。在你的真实引导强度、真实求解器下,扫 γ ∈ [0.95, 1.15],同时记录滞后 RMS 和你的任务指标。论文的核心教训是最优增益是设置相关的。
- 顺带做等范数方向控制:论文告诉我们"推力的方向比范数更重要"(垂直响应 FID 8.4 vs 平行响应 12.1)。这说明单纯"多走一步"不行——值得检查你的改进是否真的在沿学习到的速度方向推进。
- 值得新做的一件事:论文的探针只用类别标签。对 3D 医学影像,把探针条件换成"模态 + 年龄 + 中心"这类你实际拥有的元数据,可能得到更有意义的滞后估计。这是论文没做但框架允许的扩展。
上一篇(GT,2610.07555)改的是训练期的耦合,需要重训;这一篇(Velocity Scaling)改的是推理期的采样,可以立刻用在已训练模型上。而且这一篇的收益集中在低 NFE——正是 3D 医学影像的典型约束。所以如果你的目标是"让现有 3D 生成器变好",这一篇的可操作性明显更高。
两者在概念上也不冲突:GT 关于"耦合选择要在实际引导流下评估"的论点,与本文"最优增益随引导强度变化"的发现,其实是同一个方法论主题的两个实例——推理期的干预会改变训练期组件的优劣排序。
09 — 批判性评估
哪些站得住,哪些要存疑
站得很稳
- 推翻旧解释的论证是闭合的:既给了理论(方差恒等式把"缺口"定义为条件目标方差),也给了直接测量(最优乘子 = 0.999,20 个时间点)。
- 探针校验做得极好:真实时间移 0.05 → 读数变 0.0499;垂直位移同距离 → 只变 0.00519。这个对照把"探针到底在测什么"钉死了。
- 控制实验覆盖了主要替代解释:欠缩放、Euler 误差修正、端点矩匹配,三者被分别排除(附录 F)。
- 诚实的否证:明确拒绝了"单一密度幂系数"解释(残差方差比 1.14,几乎零解释力),还给了匹配高斯对照证明方法本身有效。
- 成本与稳定性数据完整:标定成本、轨迹数敏感性、探针种子稳定性都报了。
- 不确定性处理规范:配对图像/轨迹区间、2,000 次重采样,并诚实标注区间不含重新训练探针的不确定性。
要打折看
- 核心因果链仍未闭合:"滞后减少 → 质量提升"是相关性。最尖锐的证据是:径向控制与速度缩放施加等范数的额外推力,但一个让 FID 变好(7.8)、一个让它变坏(19.4)。这证明方向重要,但也说明"状态前进了多少"本身不足以解释收益。
- 滞后只解释 15–81%。剩下那部分的机制(κ、协方差锐化)论文明确说"不建立因果"。
- κ 规则的误差在高 NFE 变大:SiT-S/2 和 XL/2 在 NFE 250 的带符号误差达 +0.026 / +0.025,比低 NFE 差一个量级。用一个倍率外推到精细采样并不稳。
- "每个模型一个 κ"更像曲线拟合:论文自己承认它"描述了观测到的增益,但不建立两个独立因果机制,也不给出精细积分下的极限倍率"。
- 最优增益的定义依赖单一指标。§7.3 显示 FID 与 sFID 偏好的增益不同,precision/recall 也反向。所以"最低 FID 增益"本身就是一个指标特定的量。
证据空缺
- 完全没有图像之外的域。只有 ImageNet 与 CIFAR-10。所谓"跨架构"是 SiT / ADM U-Net / NCSN++,全在 2D 图像上。没有视频、音频、3D、科学场。
- ODE–SDE 对比不隔离噪声:附录 J 自己承认"SiT 的 ODE–SDE 比较改变了整套积分规则,因此没有隔离随机噪声的作用"。而冻结场控制显示 ODE 与 SDE 下机制权重差别很大(22% vs 54%)。所以"随机采样下大部分收益来自变化状态响应"这个结论,其对照并不干净。
- 标定区间不含探针重训不确定性:论文明确说区间"条件于训练好的探针与真实状态基线"。而三个种子都选出 1.04 只是在一个设置(SiT-XL/2、NFE 50)上的检查。
- 滞后探针的精度-方差问题被回避:论文说"固定真实时间下探针读数方差很大,所以只能跨样本平均"。这意味着单条轨迹无法估计自己的滞后——所以增益只能作为全局常数,不能做 per-sample 自适应。这一点限制很实际,但论文没有深入讨论。
- 没有与其它采样期方法的正面对比:相关工作提了 Time-Shift Sampler、Epsilon Scaling、blind denoising 等,但实验里没有横向比较。而它们针对的是同一个 state–time mismatch 问题。
- 代码尚未发布:可复现性声明写"Code will be released soon"。
值得追问的技术问题
- 为什么滞后只解释一部分?这是全文最大的开放问题。论文观测到 FID 最优增益总是高于滞后增益,且这个差距在积分变精细后仍然存在(即使滞后已很小)。他们提出"协方差锐化"作为候选(相对幂斜率 ≈1.06),并用它把更高 NFE 的增益预测到最低 FID 的 0.2 以内——但这仍是用结果拟合结果。为什么"锐化"会改善 FID?论文没答。
- 滞后探针的方差有多大?论文只说"很大,所以取平均",但没给具体数值(除了 RMS 表格)。这个方差决定了 γlag 的统计精度上限。如果单样本探针噪声极大,那么"用 256 条轨迹标定到 0.01 分辨率"的可靠性就值得核算。
- 为什么增益在高引导下要降到 1 以下?论文排除了速度幅度解释(每单位引导只增 2.6%–3.0%),也指出滞后增益只从 1.027 降到 1.021,而 FID 最优从 1.000 降到 0.950。那么这 0.05 的下降到底是什么?论文只给出了"与精度-召回权衡有关"的定性暗示。这是一个明显的机制缺口。
- 径向控制为何伤害这么大?等范数推力、同样在移动状态上重评估,径向方向却让 FID 从 13.9 涨到 19.4。这说明"状态是否真的沿学习到的速度场前进"是关键,而不只是"状态前进了"。但论文没有进一步分析为什么径向方向会系统性地破坏生成。
- CIFAR-10 的"小滞后"是模型属性还是数据属性?论文只说该模型"几乎无滞后"、最优增益恒为 1。但 CIFAR-10 同时是更小的图像、更低的维度、decoder-free、不同训练目标。到底是哪一个因素消除了滞后?做不了消融就无法回答。
- 能否做 per-sample 自适应增益?既然滞后因样本而异(探针读数方差大),理论上可以按样本选增益。论文避开了这一点(只做全局常数),但这是最有实用价值的方向之一——尤其对医学影像里"难样本/易样本"差异极大的情形。
这是一篇方法论上很漂亮的"纠错型"论文:它拆掉了一个被广泛接受但错误的解释,用一个经过严格校验的探针给出了新机制,用控制实验排除了主要替代假说,还把机制变成了不需要图片指标的标定流程。它最扎实的地方是推翻旧解释的那两步(理论 + 0.999 的直接测量)以及探针的方向控制。
它的软肋是因果链没有闭合:滞后只解释 15–81% 的收益,剩下那部分的机制(κ、协方差锐化)是描述性的;而最尖锐的径向控制实验既支持"方向重要",也削弱了"状态前进多少"的解释力。加上全部实验限于 2D 图像、代码未发布、ODE–SDE 对照不隔离噪声,它的结论应该被读作"滞后是一个真实且可测量的机制,很可能是主要机制,但不是全部",而不是"缩放就是在修滞后"。
10 — 速查
一页带走
核心公式
| 式 | 内容 | 作用 |
|---|---|---|
| (1) | Xt = (1−t)X₀ + tX₁ | 线性训练路径 |
| (2) | v*(x,t) = 𝔼[U | Xt = x] | 群体最优速度场(精确传输) |
| (3) | vθγ(x,t) = γ(t)·vθ(x,t) | 速度缩放:只乘速度,不乘状态/噪声 |
| (4) | 𝔼[‖U‖²|Xt] = ‖v*‖² + 𝔼[‖U−v*‖²|Xt] | 推翻旧解释:缺口 = 条件目标方差,不是缺失速度 |
| (5) | γ̂FM(t) = 𝔼⟨vθ,U⟩ / 𝔼‖vθ‖² | 检验欠缩放;实测均值 0.999 |
| (6) | δ̂φ(t) = 𝔼pt[ŝφ] − 𝔼qtu[ŝφ] | 群体时间滞后的定义 |
| (8) | xt + γh·vt ≈ xt+h 当 γ(τ−t) ≈ h | 缩放为何能"追赶"的一阶论证 |
| (9) | Δk+1 = Δk + 直接额外推力 + 变化状态响应 | 控制实验的分解基础 |
| (10) | γ*FID(N) ≈ κ·γlag(N) | 滞后之外的额外增益,每模型一个 κ |
| (34) | γlag = argminγ (1/K)Σ δ̂φ(ti;γ)² | 无图片指标的标定目标 |
| (45) | log Vargen,j = a + b·log Vardata,j | 端点协方差锐化的幂律斜率 |
术语对照
| 术语 | 含义 |
|---|---|
| Velocity scaling | 采样时把学习到的速度场乘以增益 γ(t)。不改训练、不改架构。 |
| Population time lag | 群体时间滞后。模型时间 t 的生成状态在真实路径上"读起来"更早。本文的核心概念。 |
| Catch-up | 追赶。减小群体时间滞后的过程。 |
| Model-time correction | 模型时间校正。把喂给网络的 t 换成 t − δ̂φ(t),不改积分时钟、不乘速度。 |
| Population field v* | 群体场。v*(x,t) = 𝔼[U|Xt=x],即 MSE 的群体最优解,精确输运源到数据。 |
| Velocity deficit | 速度缺口。前人认为 MSE 训练导致速度幅度系统性偏小——本文否定了这个假说。 |
| Changed-state response | 变化状态响应。在移动后的状态上重新评估模型所带来的那部分差异。随机采样下贡献主要收益。 |
| Frozen-field control | 冻结场控制。沿记录的无缩放速度乘增益,从不重评估模型 → 排除变化状态响应。 |
| Radial control | 径向控制。等范数但方向改为径向的额外推力 → 让 FID 变差,证明方向重要。 |
| γlag | 滞后增益。最小化测得群体滞后选出的常数增益,标定过程不用任何图片指标。 |
| γ*FID | 最低 FID 增益。在增益网格上实测 FID 最低的点,总是高于 γlag。 |
| κ | 每模型一个的倍率,γ*FID ≈ κ·γlag。描述滞后之外的额外增益,非因果机制。 |
| SSC | Scale Schedule Corrector(Li 等 2026b)。前人的时变增益 γ(t)=1.1−0.1t,本文的主要对照对象。 |
| NFE | Number of Function Evaluations,模型调用次数。低 NFE = 粗采样 = 滞后大 = 增益收益大。 |
如果你要自己试(最短路径)
- 第 0 步 · 诊断:训一个探针(状态 → 估计时间),测无缩放采样下的滞后 RMS,看它是否随 NFE 下降而增大。如果滞后很小,直接放弃这条路(CIFAR-10 就是这种情况)。
- 第 1 步 · 时间校正:先试 t → t − δ̂(t)。它不改编积分、比缩放更干净,且在随机采样下能跨架构迁移。
- 第 2 步 · 用滞后标定增益:最小化滞后 RMS 选出 γlag,分辨率 0.01、每候选 256 条配对轨迹就够。完全不碰你的评价指标。
- 第 3 步 · 在你的设置下重扫:不要照抄 1.15。在你的真实引导强度、真实求解器下扫 γ ∈ [0.95, 1.15]。论文已证明最优增益随引导、求解器、指标变化,引导强时甚至会降到 1 以下。
- 第 4 步 · 做方向控制:验证收益是否来自"沿学习速度方向前进"(论文:垂直响应 FID 8.4 / 平行 12.1 / 完整 7.7)。这是排除"只是多走了一点"的最快方法。
- 优先级判断:低 NFE + 无引导/弱引导 → 收益最大;高 NFE + 强引导 → 收益最小甚至为负。